【学习笔记】小米把 RL 训练过程搬上直播:烧钱计数器、显卡故障与 2067 个训练指标全公开,这自信从哪来
朋友丢给我一个链接:https://mimo.xiaomi.com/rl/,附了一句”这是要怎样的自信才能这样做啊”。我打开看了一个小时,结论是:这不是一个发布会页面,这是一间把墙拆掉的机房——训练花了多少钱(每秒跳动)、跑到了第几步、哪张卡出了显存故障、哪类错误三个小时没被检测出来导致重启、25 个数据源各自贡献了几条样本,全部实时挂在公网上。行业里连 wandb 截图都很少外传,小米把整个内部监控面板直播了。
这篇笔记分三层:先用浏览器一手拆页面本身(数字截至 2026-09-17 中午,北京时间);再结合罗福莉的官宣推文和量子位的报道,梳理这套直播背后的方法论;最后聊聊我的看法——这种”自信”到底是什么,以及它值不值。2026-09-19 凌晨我复访了一次直播页,最新数据与两起新故障记在第十节。
一、这是什么:一个挂在公网上的训练仪表盘
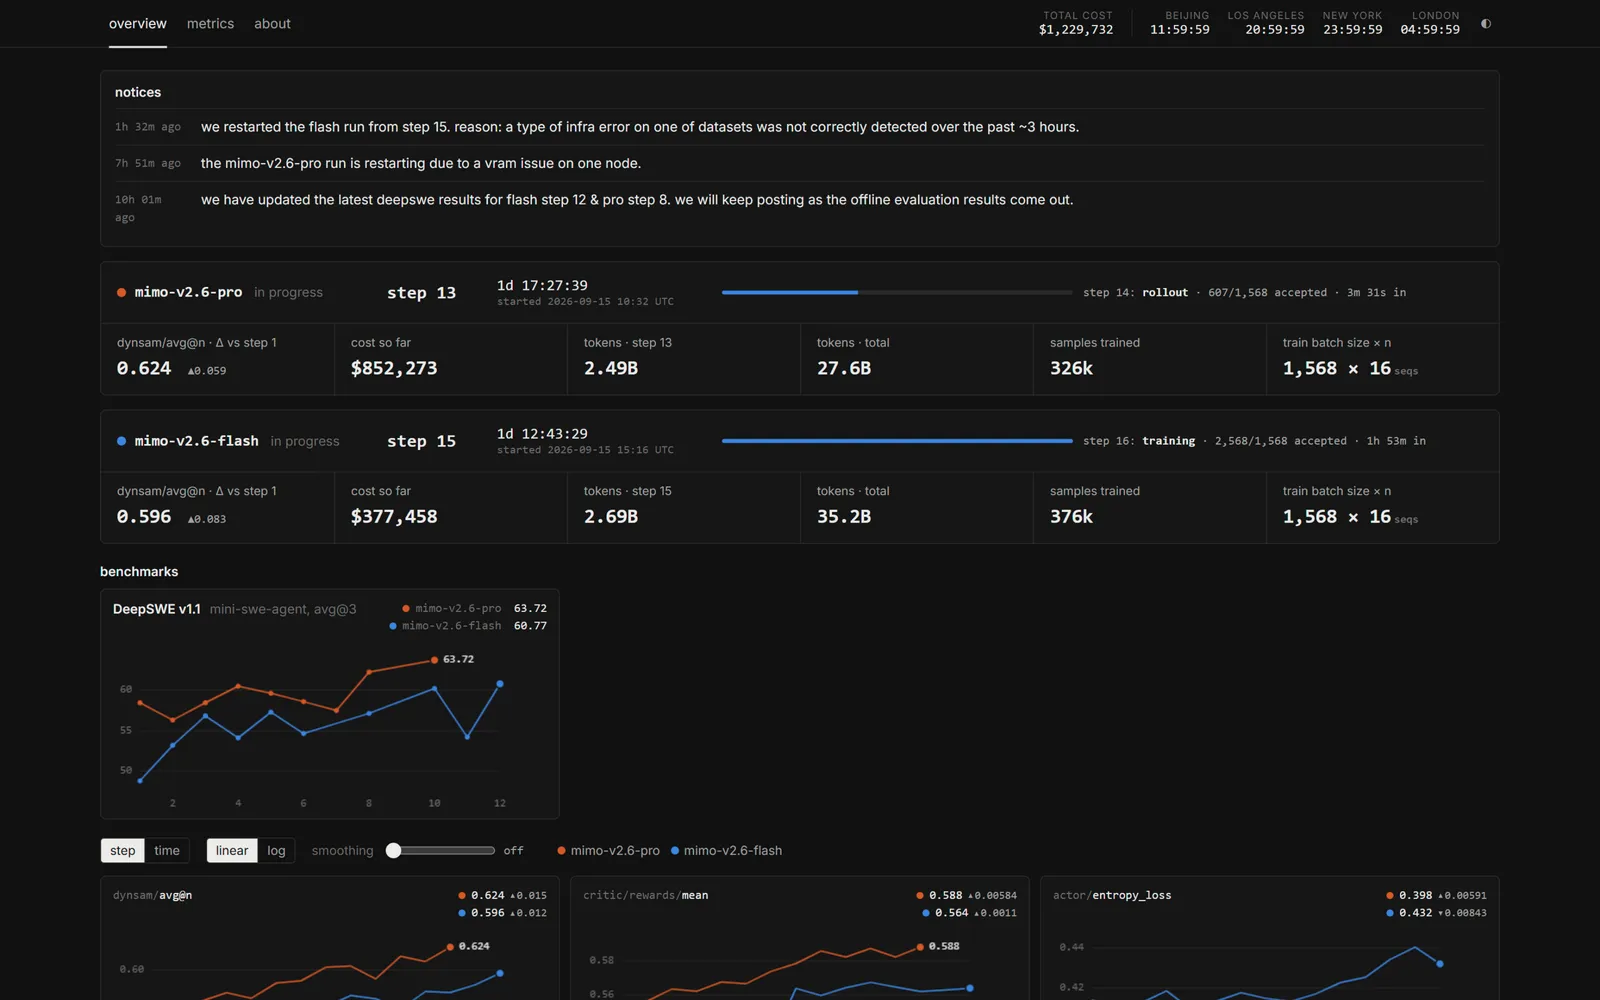
页面叫 mimo-v2.6 RL,顶部三个页签:overview / metrics / about。没有营销文案,没有 logo 墙,右上一排四个时钟(北京 / 洛杉矶 / 纽约 / 伦敦)和一个不断跳动的 total cost 计数器——我截图时它已经过了 $1,228,987,一分钟后再看是 $1,229,512。
about 页签只有三句话,坦白得近乎潦草:
We are streaming our RL big runs. The mimo-v2.6 series is coming soon. Follow us @XiaomiMiMo.
页脚两行小字更有味道:streaming since 2026-09-16 04:00 UTC(开播时间),以及一句口号——Open is what we value.
几个值得注意的时间线细节:
- 两条 run 分别启动于 2026-09-15 10:32 UTC(pro) 和 15:16 UTC(flash),而直播开播于 09-16 04:00 UTC——也就是说 pro 跑了约 17 个半小时之后才”开机镜头”。不是从第 0 步开始裸奔,是确认系统跑顺了才开播。
- 量子位当天上午的报道标题就是《罗福莉沉寂半年官宣小米强化学习!直播新模型训练过程,一小时烧 3 万美元》——自今年 4 月开源 MiMo-v2.5 之后,小米大模型团队沉寂了近半年,这次回归的方式不是发论文,而是开直播。
二、正在直播的两条 run:数字对账
overview 的主体是两张实时状态卡,对应同时在训的 mimo-v2.6-pro 和 mimo-v2.6-flash。以下是我 2026-09-17 中午(北京时间)抓到的一帧:
| 指标 | mimo-v2.6-pro | mimo-v2.6-flash |
|---|---|---|
| 状态 | in progress,step 13(正在跑 step 14 rollout) | in progress,step 15(正在跑 step 16 training) |
| 启动时间 | 2026-09-15 10:32 UTC | 2026-09-15 15:16 UTC |
| 已运行 | 1 天 17 小时 26 分 | 1 天 12 小时 42 分 |
| dynsam/avg@n(对比 step 1) | 0.624(▲0.059) | 0.596(▲0.083) |
| 花费 | $851,775 | $377,212 |
| 每步 token | 24.9 亿 | 26.9 亿 |
| 累计 token | 276 亿 | 352 亿 |
| 已训练样本 | 32.6 万 | 37.6 万 |
| batch 配置 | 1,568 prompt × 16 rollout | 1,568 prompt × 16 rollout |
两个可以自己动手验的账,验完会对这个页面的认真程度有个判断:
- 花费对得上:$851,775 + $377,212 = $1,228,987,和页顶 total cost 一分不差。按各自运行时长折算,pro 约 $2.05 万/小时、flash 约 $1.03 万/小时,合计约 $3.1 万/小时——和量子位”一小时烧 3 万美元”的口径互相印证。
- token 对得上:1,568 × 16 = 每步 25,088 条轨迹,除进 24.9 亿 token,得出平均每条轨迹约 10 万 token——这正是 Agentic RL(模型在环境里多轮操作、长上下文)该有的量级,而不是一问一答式短轨迹 RL。
三、直播到底”播”了什么:那些平时绝对看不到的东西
真正让我觉得”这要怎样的自信”的,不是钱,是故障和内脏。
3.1 公告栏:训练现场的脏活,原样贴出
overview 顶部有个 notices 区,我抓到的三条原文(英文原文照抄):
1h 30m ago — we restarted the flash run from step 15. reason: a type of infra error on one of datasets was not correctly detected over the past ~3 hours.
7h 50m ago — the mimo-v2.6-pro run is restarting due to a vram issue on one node.
10h 00m ago — we have updated the latest deepswe results for flash step 12 & pro step 8. we will keep posting as the offline evaluation results come out.
翻译一下:一台节点显存出问题导致 pro 重启;flash 因为某类基础设施错误三个小时没被正确检测出来,从 step 15 重跑。这种事在任何实验室都是内部复盘文档里才会出现的句子,写进对外技术报告都算”过于坦诚”,小米把它贴在了直播首页。
3.2 metrics 页签:2067 个内部指标 tag
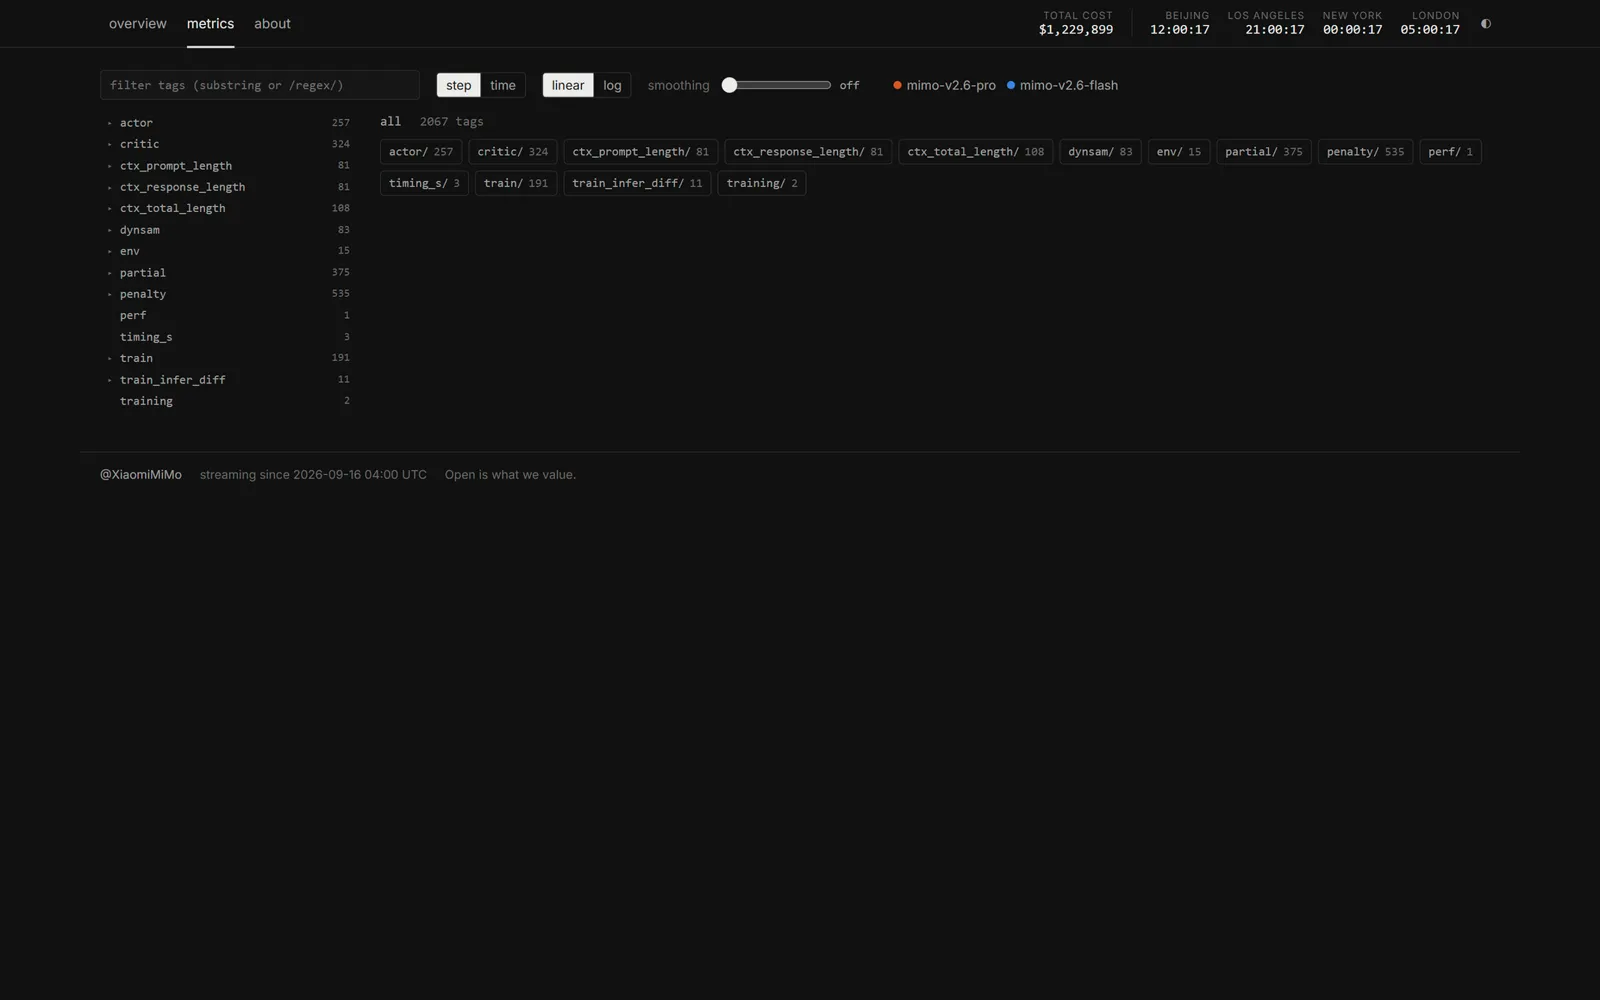
切到 metrics 页签,左边是一棵可搜索(支持正则)的指标树,底部一行小字:all · 2067 tags。分组统计大致是:
| 指标组 | tag 数 | 指标组 | tag 数 |
|---|---|---|---|
| penalty | 535 | critic | 324 |
| partial | 375 | actor | 257 |
| train | 191 | ctx_total_length | 108 |
| dynsam | 83 | ctx_prompt/response_length | 81 + 81 |
| train_infer_diff | 11 | env / perf / timing_s / training | 15 + 1 + 3 + 2 |
这是什么概念? DeepSeek 的技术报告里,你能看到的关键训练指标大概十几个;一个典型的 wandb 面板对外截图也就露几十个 tag。这里是一次性把内部监控的整棵树放出来——光 penalty(惩罚项)就有 535 个 tag,等于把他们防 reward hacking 的监控粒度直接摊开了。
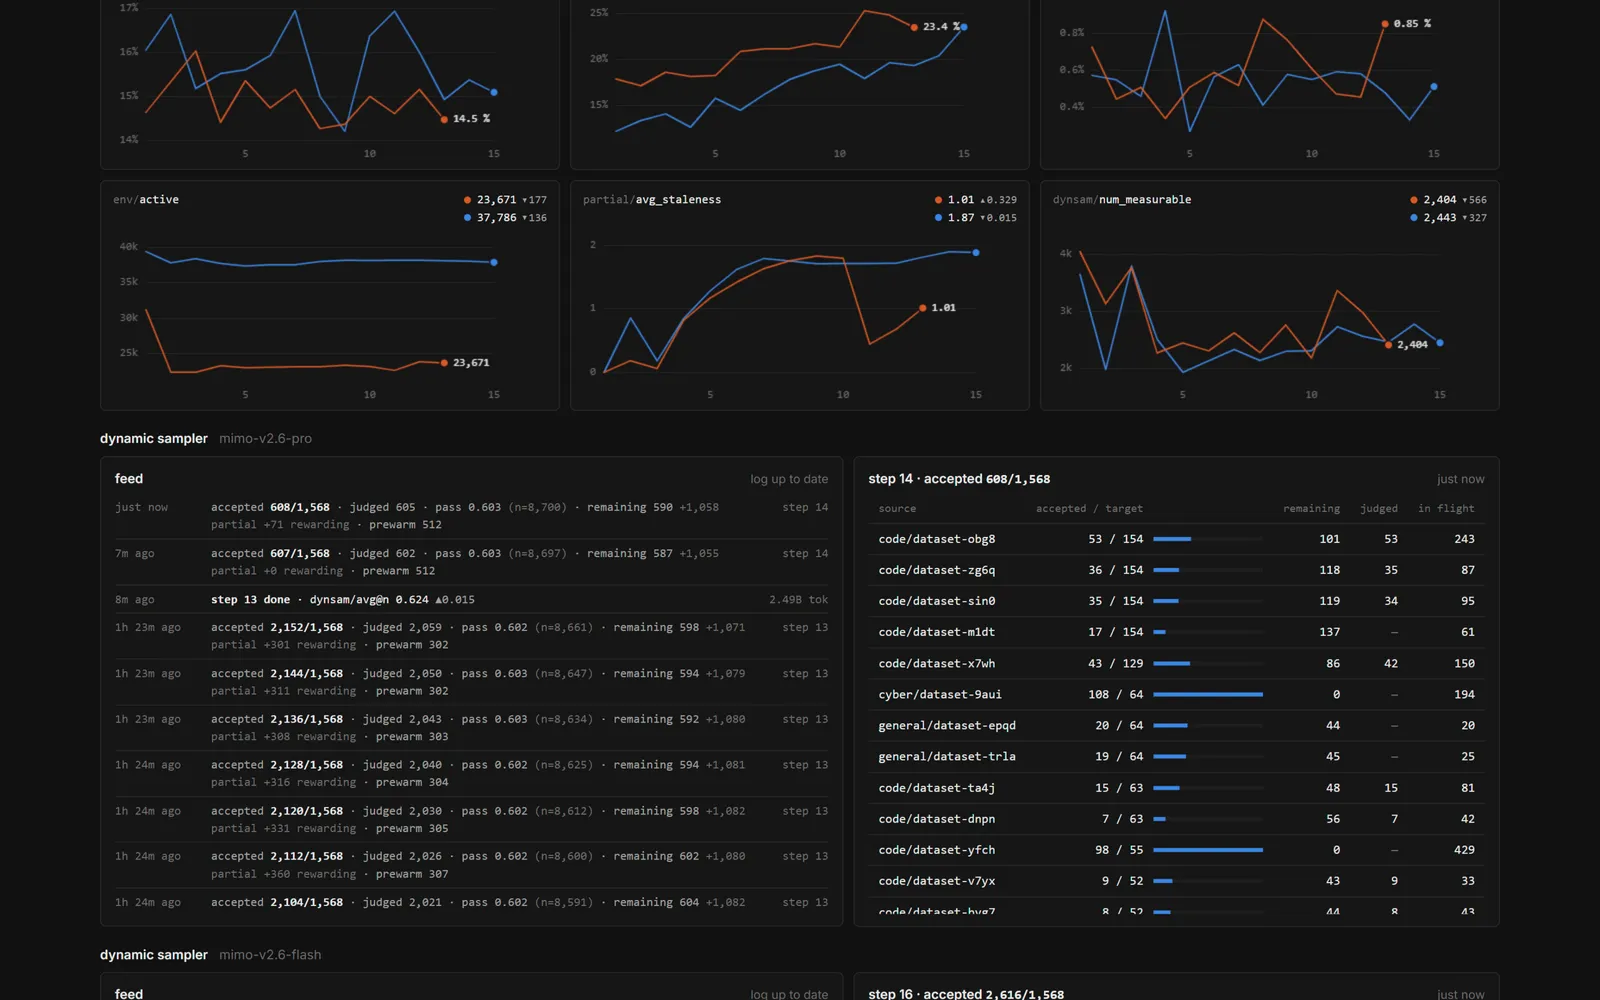
overview 里默认展示的十几个图表也够”内脏”了:actor/pg_loss、actor/entropy_loss、critic/rewards/mean、train_infer_diff/new_infer/kl(训练与推理权重不同步的 KL 散度)、partial/avg_staleness(部分 rollout 的陈旧度)、dynsam/infra_error/seq_rate(每条序列的基础设施错误率)——这些都是”读懂了就能反推他们系统设计”级别的信息,后面第八节展开。
3.3 动态采样器:细到 25 个数据源的实时表格
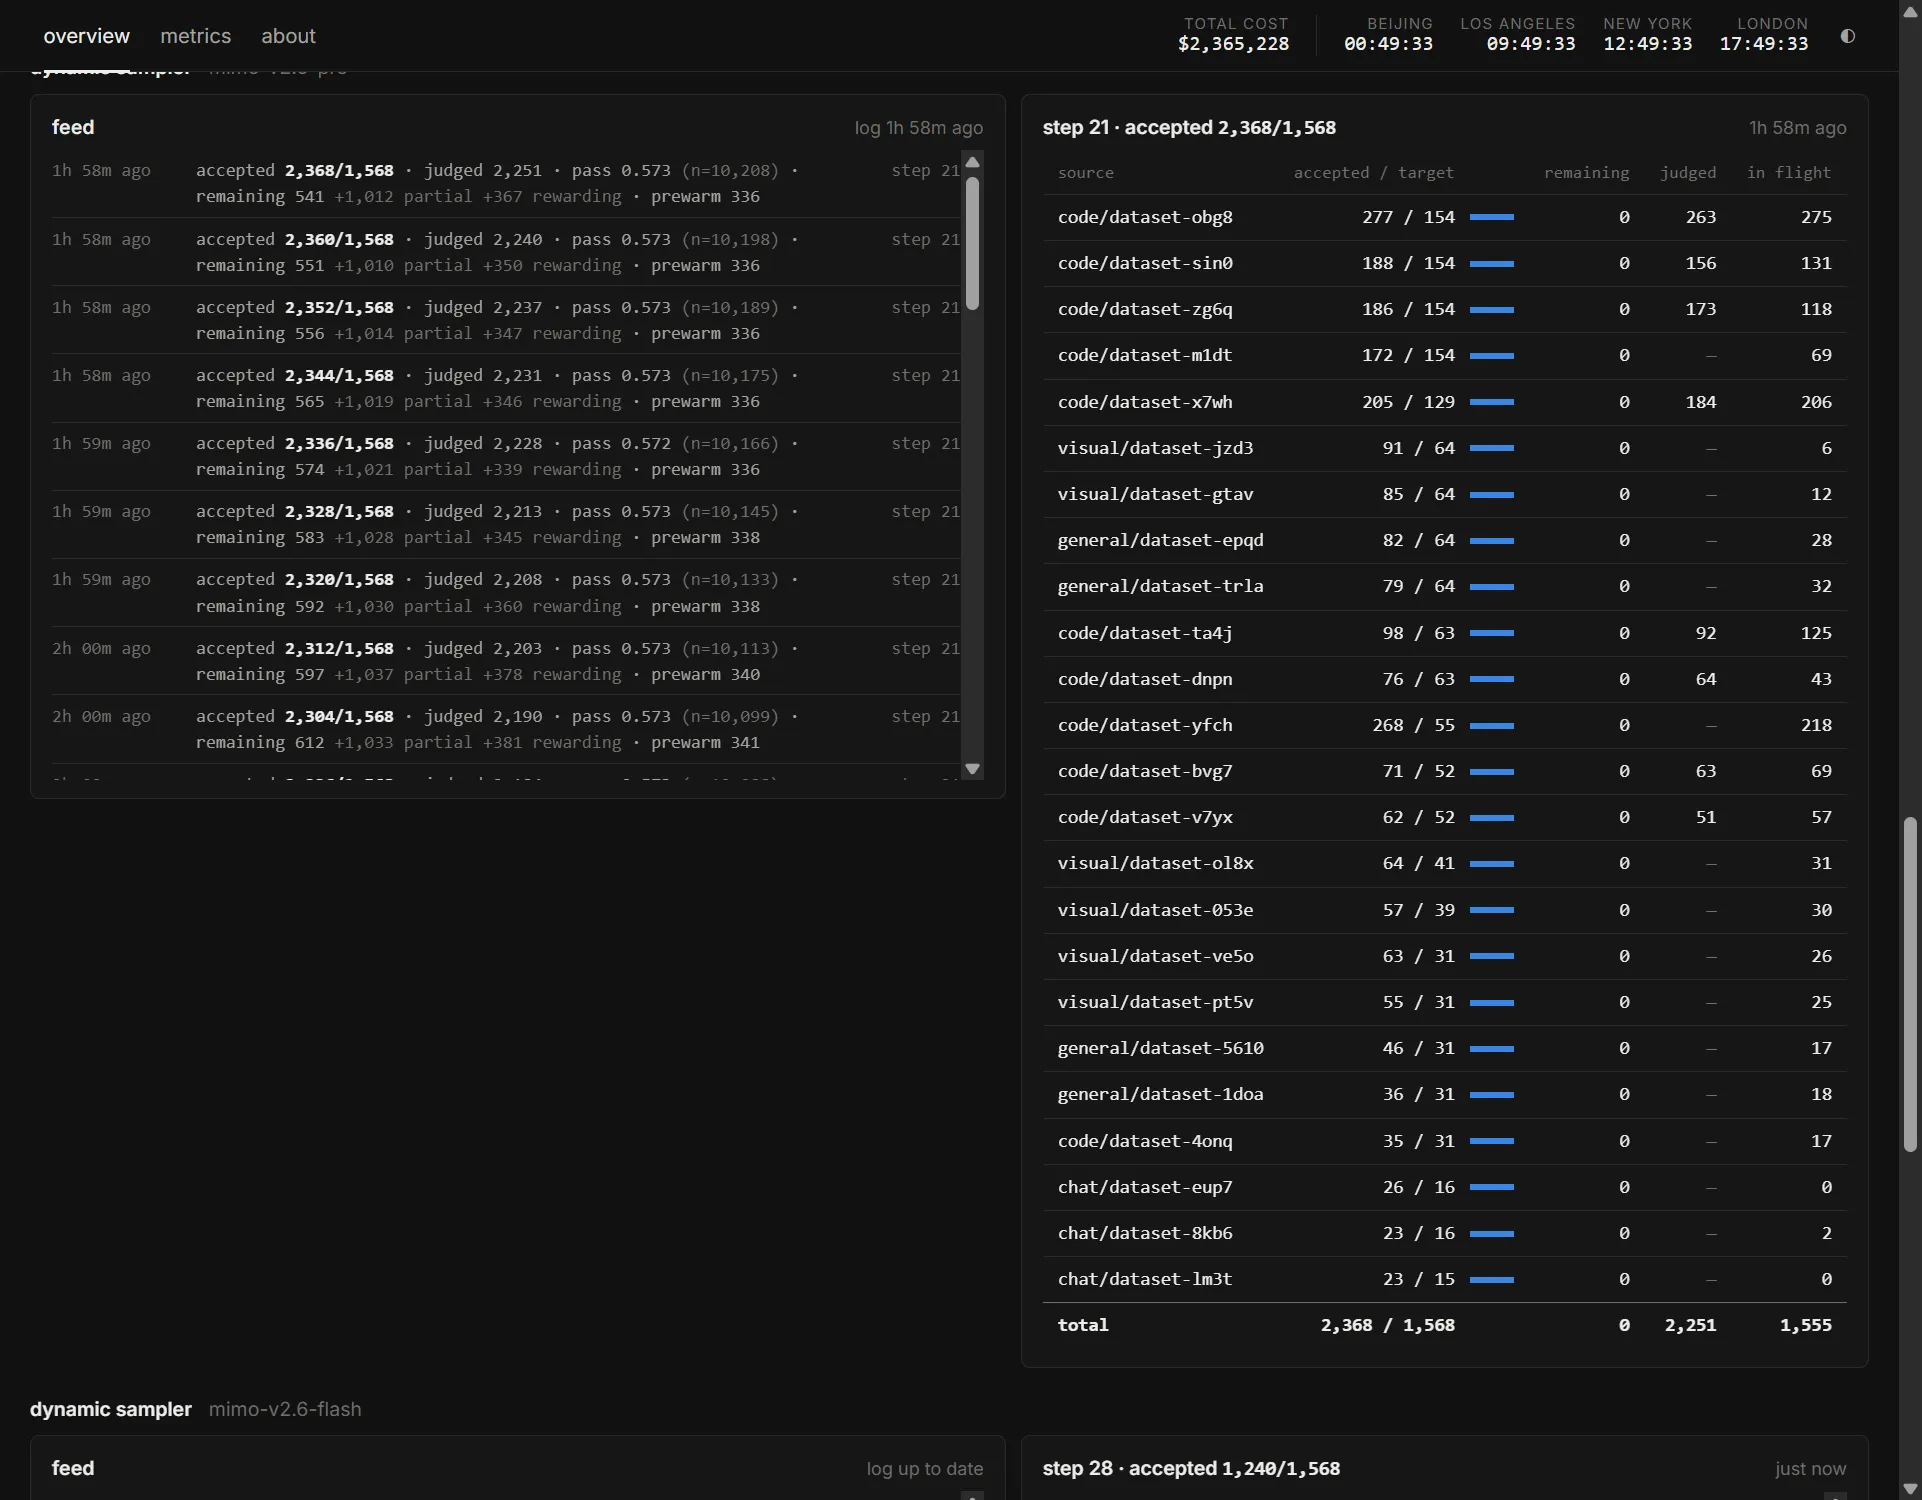
页面下方是两个 dynamic sampler 区块(pro/flash 各一),左边是逐分钟滚动的采样日志:
accepted 2,552/1,568 · judged 2,511 · pass 0.589 (n=4,331) · remaining 350 +636 partial +81 rewarding · prewarm 396
右边是一张按数据源拆开的实时表:25 个数据源(名字全部哈希化,如 code/dataset-obg8、visual/dataset-gtav、cyber/dataset-9aui、chat/dataset-8kb6),每个源当前 accepted / target / remaining / judged / in flight 各是多少。你能实时看到哪个数据池快采干了、哪个源的样本还在沙箱里跑着。
3.4 batch composition:每一步的配方也公开
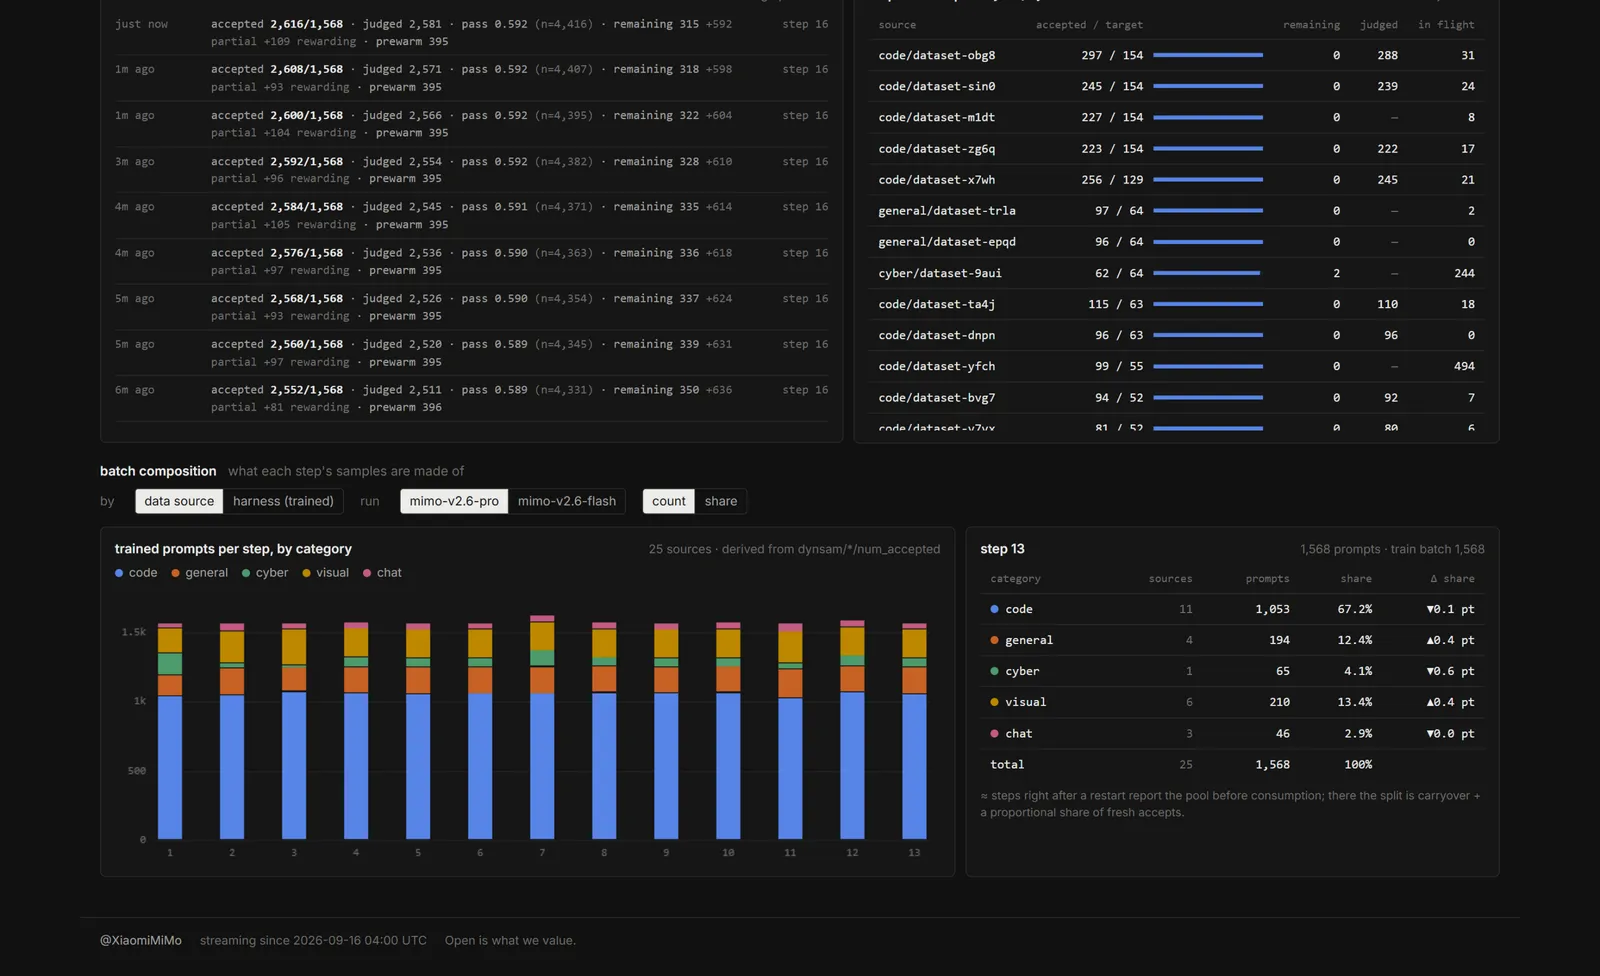
最后一节把每个 step 的 1,568 个 prompt 按 five-way 拆开——我抓到的 step 13:code 67.2%(1,053 条)、visual 13.4%、general 12.4%、cyber 4.1%、chat 2.9%,25 个源,页面还标注”derived from dynsam/*/num_accepted”(由动态采样器的接受数导出),并附了一行小字解释重启后的 step 为什么统计口径特殊。
四、钱:每秒约 9 美元的计数器
把三次抓帧串起来:11:58:33 是 $1,228,987,11:59:09 是 $1,229,309(36 秒涨 $322),11:59:33 是 $1,229,512(24 秒涨 $203)。折算下来每秒 8.5–9 美元、每小时约 3.1 万美元、每分钟约 3,800 元人民币——量子位写的”一眨眼 10 美元、一分钟 4000+ 人民币、平均每小时 3 万美元”全部对得上。
值得强调的是:把成本数字公开,本身就是个异类行为。模型厂商对外报价单上只有 API 单价,训练成本从来是最高机密之一(外界只能靠 GPU 数量 × 时间去估)。直接挂一个实时计数器,等于把自己的 GPU 租金、利用率、并行效率打包成一个数字,接受全网审视。
五、成绩单:坦白说,还在追赶
直播页自己也贴基准:DeepSWE v1.1(mini-swe-agent,avg@3),我抓到的最新数字 pro 63.72、flash 60.77——notice 里说这是 flash step 12 / pro step 8 的离线评测结果,会随训练推进持续更新。
对比一下:量子位引用的参照系里,DeepSeek-Flash(v1.1)在同一基准上是 74.2%。也就是说,直播中的 MiMo-V2.6 距离第一梯队还有两位数的差距,而小米把这个”暂时落后”的状态原样挂在网上。训练侧的收益倒是清晰可见:核心学习信号 dynsam/avg@n 从 step 1 到 step 13/15,pro 从 0.565 → 0.624,flash 从 0.514 → 0.596(量子位引用的 0.614 是当天早些时候的帧)。
敢直播落后,比敢直播烧钱更少见。
六、自信从哪来:罗福莉的”三维度 Scaling”
9 月 16 日,小米大模型团队负责人罗福莉(@_LuoFuli,简介”Xiaomi MiMo, formerly DeepSeek”)发了官宣推文(单条,非线程,当天破百万浏览):过去半年团队基本只研究了一件事——RL 能扩展到多远(how far RL can scale),MiMo-V2.6 正在途中,细节会在未来几周开源。结合量子位对推文的长文解读,答案是一个三维度 Scaling 框架,而这三个维度恰好就是直播页三个区块的注脚:
- 训练计算量 Scaling。每 step 约 20 亿 token,1,568 个 prompt × 每个 16 条 rollout(一轮 2.5 万+ 条轨迹),执行上采用 Fully Async 完全异步——生成、执行、评分、训练四个环节不排队,这正是 metrics 里
partial/avg_staleness(异步的代价:部分轨迹用的是落后一两步的权重)和timing_s/outer_gen、timing_s/trainer_ops(耗时分解)存在的原因。 - 环境 / Harness Scaling(Multi-task Agentic RL)。代码、通用任务、视觉、Chat 混在同一次 RL run 里,不同任务接不同 harness——就是 batch composition 表格里 code/general/cyber/visual/chat 五类 25 个源的实时配比。直播页等于把这个维度做成了可视化展品。
- 评分计算量 Scaling(Grader Compute)。给每条轨迹更细的学习信号——同一 prompt 的 16 条 rollout 在组内做 Agentic In-group Credit Assignment(组内信用分配),奖励信号结合测试用例与评分规则(test-case and rubric-based rewards)。算法细节推文说会随开源放出。
英伟达高级研究科学家 Jim Fan(量子位笔下的”ViT 大佬”,此处指其在推文下的解读)的总结很精炼:训练计算量、环境数、评分器数——这三件事背后的本质都是算力。他还补了一句”基座模型自身推一发”的展望:这套 multi-task RL 的终极形态,是让基座模型自己给自己出环境、当评分器。
七、我怎么看:把 Open 从”结果”推进到”过程”
回到最初的问题:这是要怎样的自信?
从工程上讲,这是对基础设施的自信。 敢开直播的前提是系统跑得稳、可观测性做得细。事实上直播这两天的三次公告——一次显存故障、一次三小时未检出的 infra 错误、一次评测更新——每一次都处理得干净利落,公告措辞不遮不掩。异步 RL 系统最怕静默数据损坏,他们的 dynsam/infra_error/seq_rate 和 partial/avg_staleness 就是专门盯这个的。把故障公告当直播内容,反过来说明故障是可预期、可恢复、可解释的。
从方法论上讲,这是对”曲线会涨”的自信。 直播最大的风险是训练当场翻车——奖励崩了、熵塌了、benchmark 不涨反跌,全网围观。小米敢播,是因为三维度 Scaling 的框架让他们对”加算力 → 学习信号变好”有把握。前 13~15 步的曲线也确实在涨。
从叙事上讲,这是一次把 “Open” 从名词推进到动词的操作。 页脚那句 “Open is what we value” 不是空话:行业惯例的透明是事后透明(开源权重、发技术报告),小米做的是过程透明——open weights → open report → open process。这和 DeepSeek 用技术报告倒逼行业透明是同一个方向,但激进得多。
当然,泼几盆冷水也是必要的:
- 数字全部自报,无法独立验证。计数器、曲线、benchmark 都是官方自己的仪表盘,没有第三方审计。
- 数据与算法没有全开。25 个数据源全是哈希名,数据集本身不公开;最核心的 Credit Assignment 算法”未来几周开源”——现在还只是承诺。直播 ≠ 可复现。
- 营销动机不缺席。沉寂半年的团队选”直播”作为回归方式,招聘、声量、行业地位的收益都写在脸上——这不妨碍它同时是一次真诚的透明,两件事从来不互斥。
- 对普通观众的信噪比其实不高。2067 个 tag 里绝大多数只有从业者能读懂;对大众传播真正有效的,其实是那个每秒跳 9 美元的计数器。
我的整体判断:这不是炫技,是一次把”训练大模型”这件事从黑箱叙事改成公开赛叙事的尝试。它赌的是两件事——系统不会当众崩溃,以及方法论经得起围观。至少到本文写作时,两件事都成立。
八、工程彩蛋:从指标名反推系统设计
这部分是给工程向读者的,几个我从 dashboard 里读出来的设计细节:
- dynsam(dynamic sampler)是一个七状态机。日志行里一条采样轨迹要经过
accepted → judged → pass/remaining → partial → rewarding → prewarm多个状态;accepted 2,552/1,568里接受数超过目标数,说明先超量接受、再按组配比裁剪——这是动态课程学习(按各源实时通过率调整采样权重)的标准做法,batch composition 页也明说配比”derived from dynsam/*/num_accepted”。 - 异步是有代价的,而且他们盯着这个代价。
partial/avg_staleness稳定在 1.6–1.9,即部分 rollout 由落后约两步的权重生成;train_infer_diff/new_infer/kl直接监控训练策略与推理策略的 KL 偏移——off-policy 程度被量化成了两个实时指标。 - 环境规模是六位数。
env/active显示 pro 23,671 / flash 37,786 个并发活跃环境(沙箱),加上 prewarm 预热池。2.5 万条轨迹 × 每条多轮工具调用,对应这个量级的沙箱并发,环境编排本身就是一个大工程。 - 防 hacking 的监控粒度恐怖。penalty 组 535 个 tag、
dynsam/passrate/zero与passrate/one(全组 16 条全对/只对一条的比例)分开监控——后者是识别”题目太难或太简单、学习信号退化”的关键指标。 - 横轴可切 step/time,纵轴可切 linear/log,还有平滑度滑杆——一个生产级的内部指标浏览器,只是被搬到了公网。
九、总结
mimo.xiaomi.com/rl 这个页面,用一句话概括:小米把一次 300 万美元级的 RL 训练,做成了 7×24 小时公开慢直播——烧钱速度、显卡故障、内部指标树、数据源级采样明细、暂时落后的 benchmark,全都实时可见。
它值得看两遍:第一遍看热闹,盯着计数器跳字,感受”每秒 9 美元”的物理意义;第二遍看门道,从 2067 个指标 tag 和 25 个数据源的采样表里,读出一个生产级 Agentic RL 系统的真实形状——异步、部分陈旧、动态采样、组内信用分配,以及每一层都有专门的监控在盯着它别作恶。
至于”怎样的自信”——我的答案是三层叠加:基础设施扛得住围观的自信、方法论曲线会涨的自信、以及把 Open 当核心叙事的战略自信。前两层是工程和组织能力,第三层是选择。而这三层里,最难的其实是第一层:毕竟世上多的是想直播的团队,少的是敢让故障公告上首页的系统。
后续值得追的三个点:Credit Assignment 算法几周后是否真的开源;MiMo-V2.6 系列正式发布时的 benchmark 能不能追平 74.2% 的参照系;以及这波”训练直播”会不会被其他实验室跟进——如果跟进者众,“事后才透明”的行业惯例可能就真的回不去了。
十、两天后更新(2026-09-19)
2026-09-19 凌晨 00:42(北京时间)我又开了一次直播页。先说结论:第七节的判断到此刻仍成立——系统又崩了两次、当众贴了公告,但曲线继续在涨、烧钱速度没变慢。
钱:total cost $2,361,451(pro $1,606,752 + flash $754,698 = $2,361,450,与计数器差 $1,账仍然对得上)。距离 09-17 中午那帧($1,228,987)过去 36 小时 43 分,又烧掉 $113 万——平均 $8.6/秒、约 $3.1 万/小时、每天约 $74 万,速率与首日完全一致;拆到单 run,pro 约 $2.06 万/小时、flash 约 $1.03 万/小时,也几乎没变。
公告从 3 条变成 5 条,又两次故障(这次都在 pro 上):
12h 52m ago — the pro run restarted at step 17 due to a GPU OOM issue caused by expert load imbalance. we have adjusted the training parallelism strategy.
1d 04h ago — there was a network connectivity issue between the pro training cluster and the grader deployment. we have restarted the run. we also removed the cyber dataset from the upcoming pro run, since we observed some bad patterns in the rollout logs.
第一条的 expert load imbalance(专家负载不均衡)是 MoE 架构的典型病症,算是 V2.6 为混合专家模型的一处侧证。第二条则是我认为整场直播到目前为止信息量最大的一条公告:观众第一次实时看到一个训练配方的变更决定——不是事后在技术报告里写”我们做过数据消融”,而是当场宣布”这个数据源在 rollout 里表现不对,砍了”。页面上也立刻能对上:
- pro 的 dynamic sampler 表从 25 个源变成 24 个(cyber/dataset-9aui 消失);batch composition 里 cyber 行降到 0 prompt / 0.0%(表尾 total 仍写 25 sources,把这条零配比的行也计入);省出的配比给了 visual——份额 13.4% → 17.3%,code 仍占 67.5%。
- flash 还留着 cyber,但接受数只有 2/64——同一个数据源在两条 run 里的命运对照,就挂在同一页上。
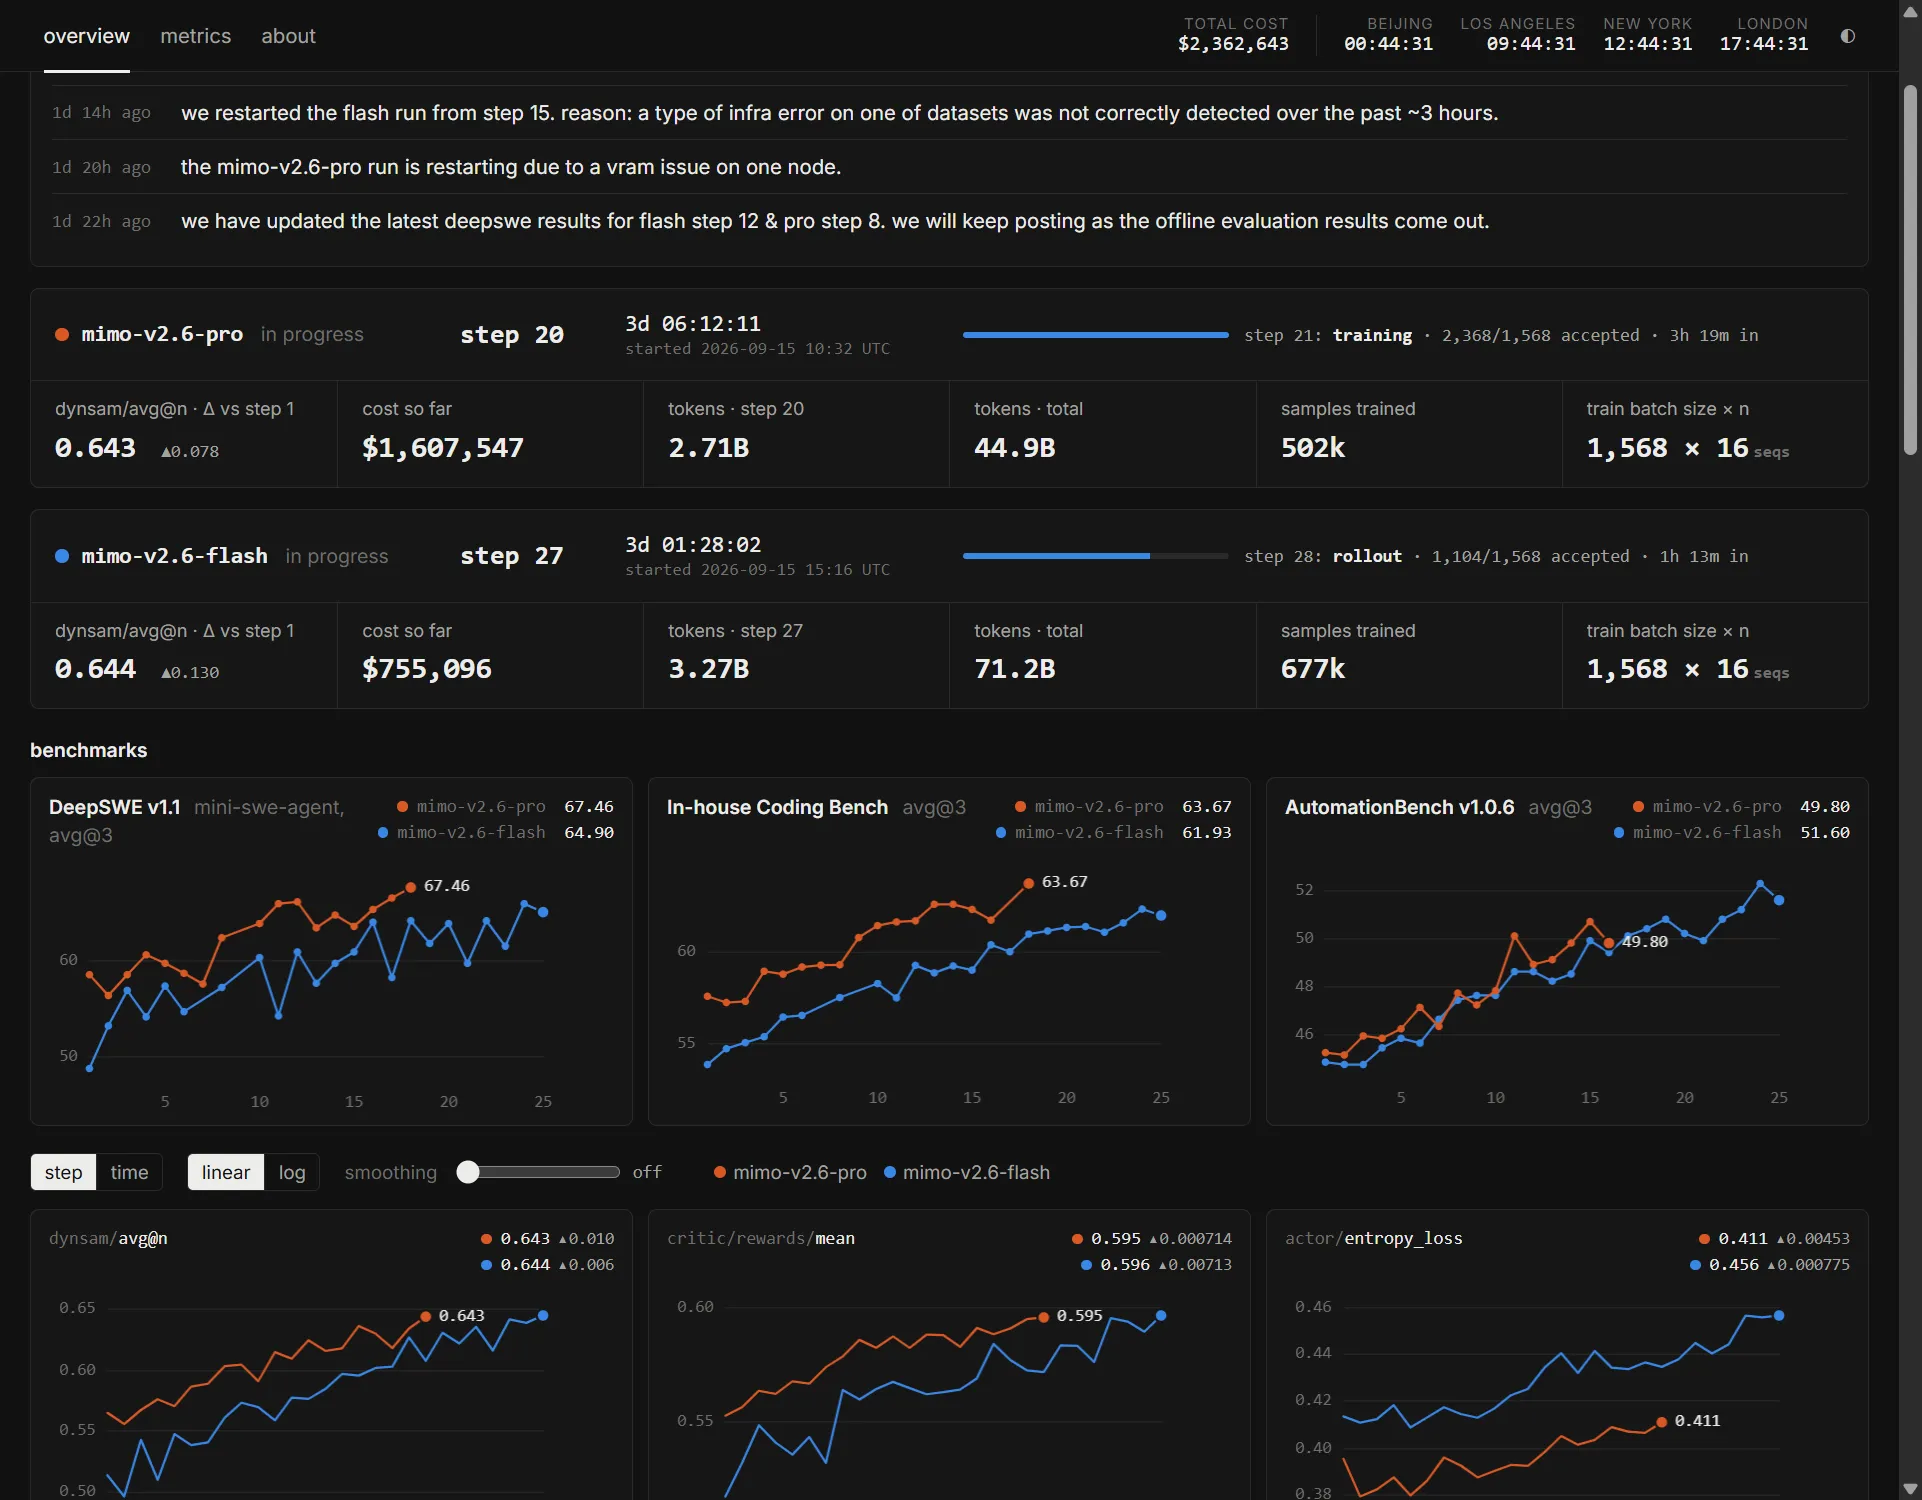
进度与成绩(箭头左侧为 09-17 抓帧,右侧为本次):
| 指标 | mimo-v2.6-pro | mimo-v2.6-flash |
|---|---|---|
| step | 13 → 20 | 15 → 27 |
| dynsam/avg@n | 0.624 → 0.643 | 0.596 → 0.644 |
| 累计 token | 276 亿 → 449 亿 | 352 亿 → 712 亿 |
| 已训练样本 | 32.6 万 → 50.2 万 | 37.6 万 → 67.7 万 |
| 花费 | $851,775 → $1,606,752 | $377,212 → $754,698 |
两个值得划线的点。其一,flash 的学习信号 0.596 → 0.644,已经追到与 pro(0.643)同一水位——从 step 15 重启那次算起,重启没有打断它爬坡。其二,benchmark 全线上涨:DeepSWE v1.1 pro 63.72 → 67.46(+3.74)、flash 60.77 → 64.90(+4.13),与 DeepSeek-Flash 的 74.2 参照系差距从 10.5 分缩到 6.7 分。页面还新增了两个基准区块:In-house Coding Bench(pro 63.67 / flash 61.93)与 AutomationBench v1.0.6(pro 49.80 / flash 51.60——这一项 flash 反超了 pro)。
一个安静的细节:metrics 页签的 tag 总数从 2067 涨到 2077,新增的 10 个全部落在 partial 组(375 → 385)——两次重启之后,监控粒度在变细而不是变粗。
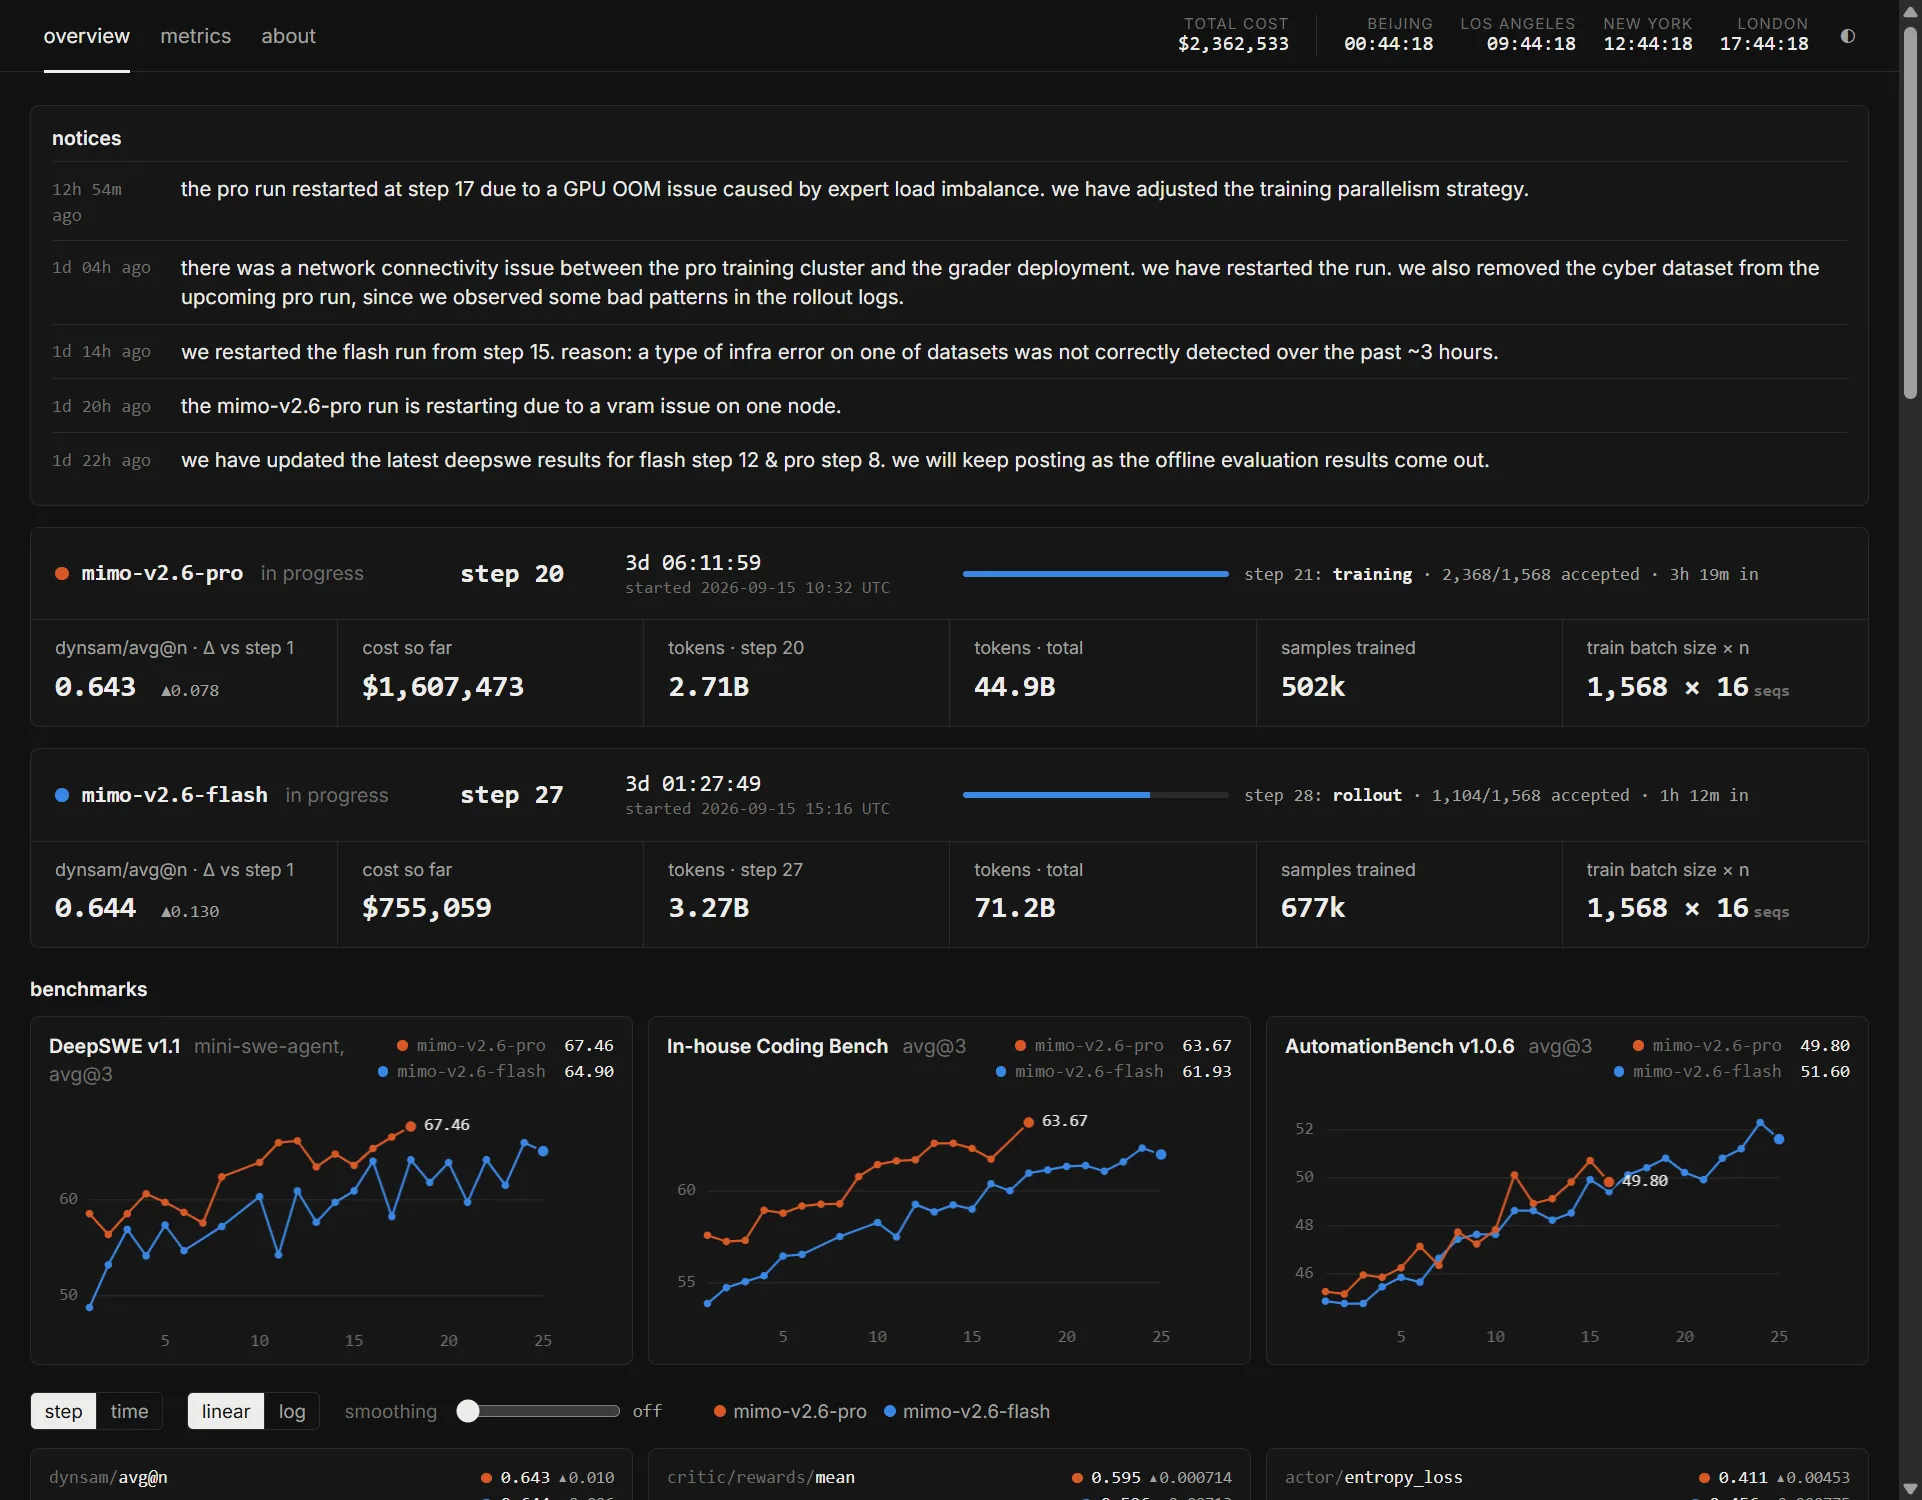
至此,直播两天半的完整故障清单:pro 三次重启(节点显存故障、grader 网络故障、step 17 的 GPU OOM)+ flash 一次重启(infra 错误 3 小时未检出)+ 一次评测更新。每一条公告的措辞都是”发生了什么 + 为什么 + 改了什么”三段式,而且没有删改过旧公告——最初三条还原样挂在下面。这大概是对”过程透明”最实在的注脚:透明不是不出故障,是故障记录不可编辑。
参考链接
- 直播页(RL training live):https://mimo.xiaomi.com/rl/
- 罗福莉官宣推文(2026-09-16):https://x.com/_LuoFuli/status/2100296686719610932
- MiMo 官方账号:https://x.com/XiaomiMiMo
- 量子位报道《罗福莉沉寂半年官宣小米强化学习!直播新模型训练过程,一小时烧 3 万美元》(2026-09-17):https://www.qbitai.com/2026/09/490950.html