【读书笔记】《高性价比人生指南》深度拆解:608 条循证建议、20 天近 2 万 star,和一本用 Claude Code 维护的书
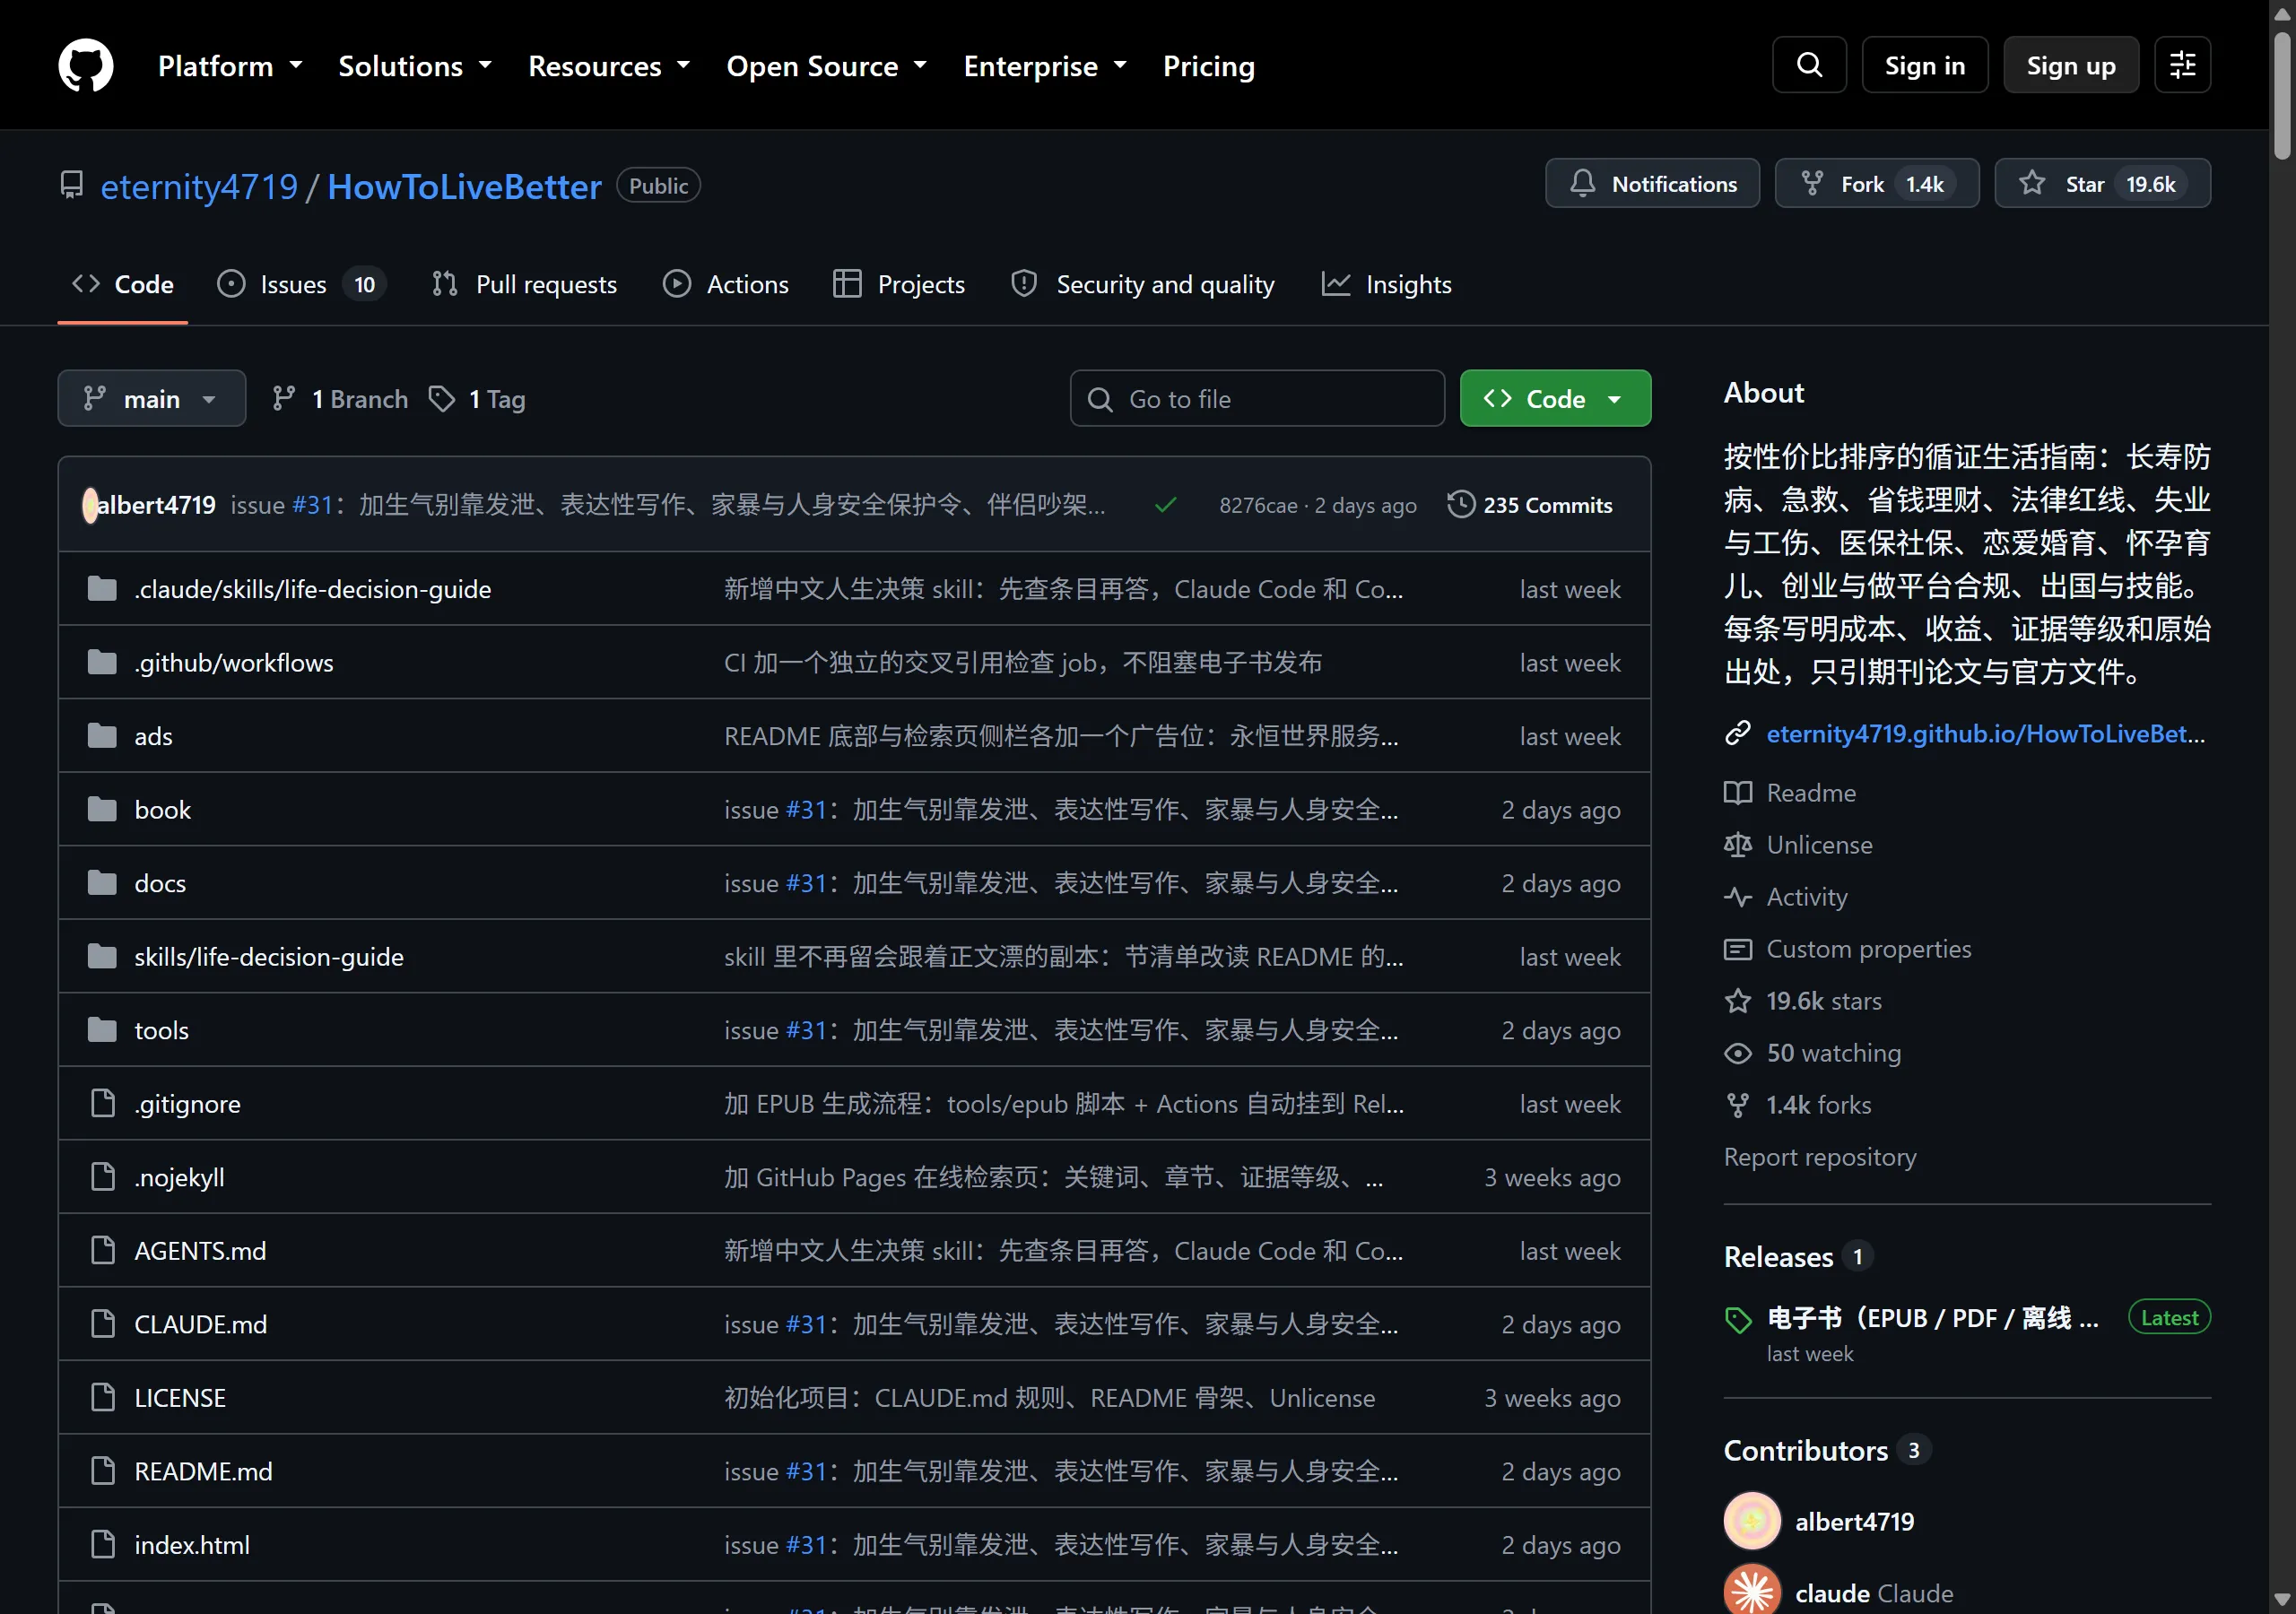
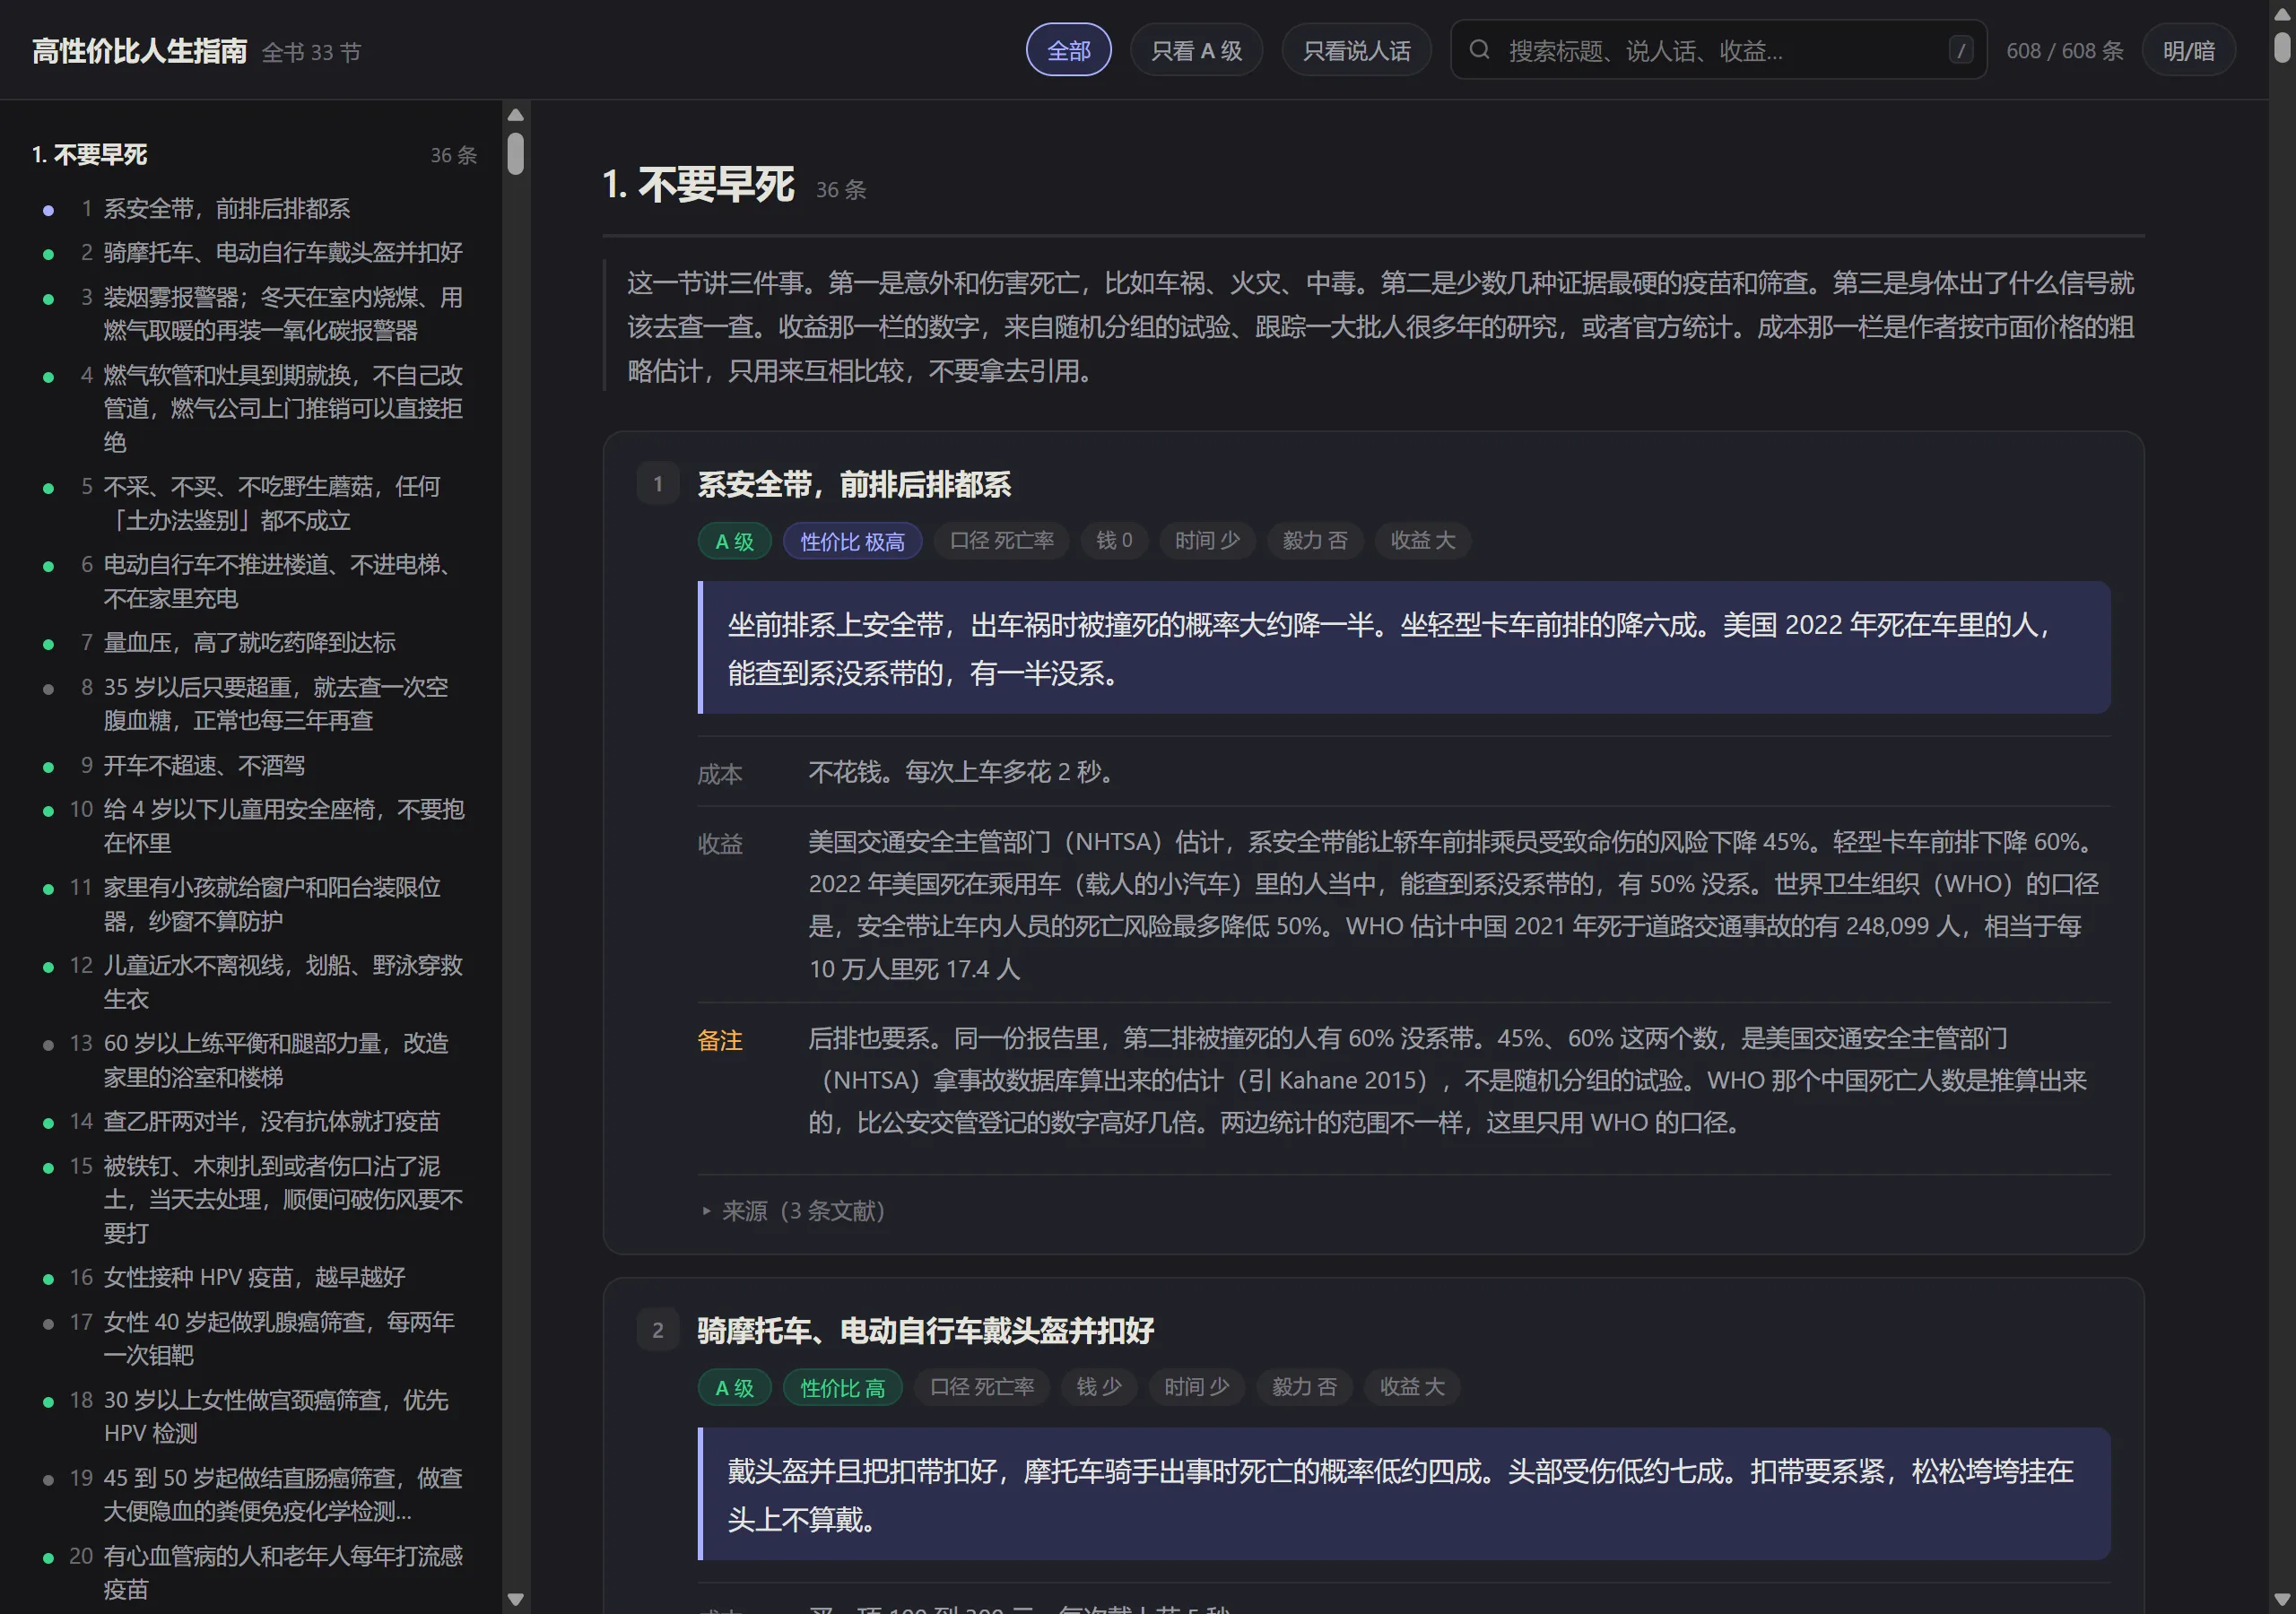
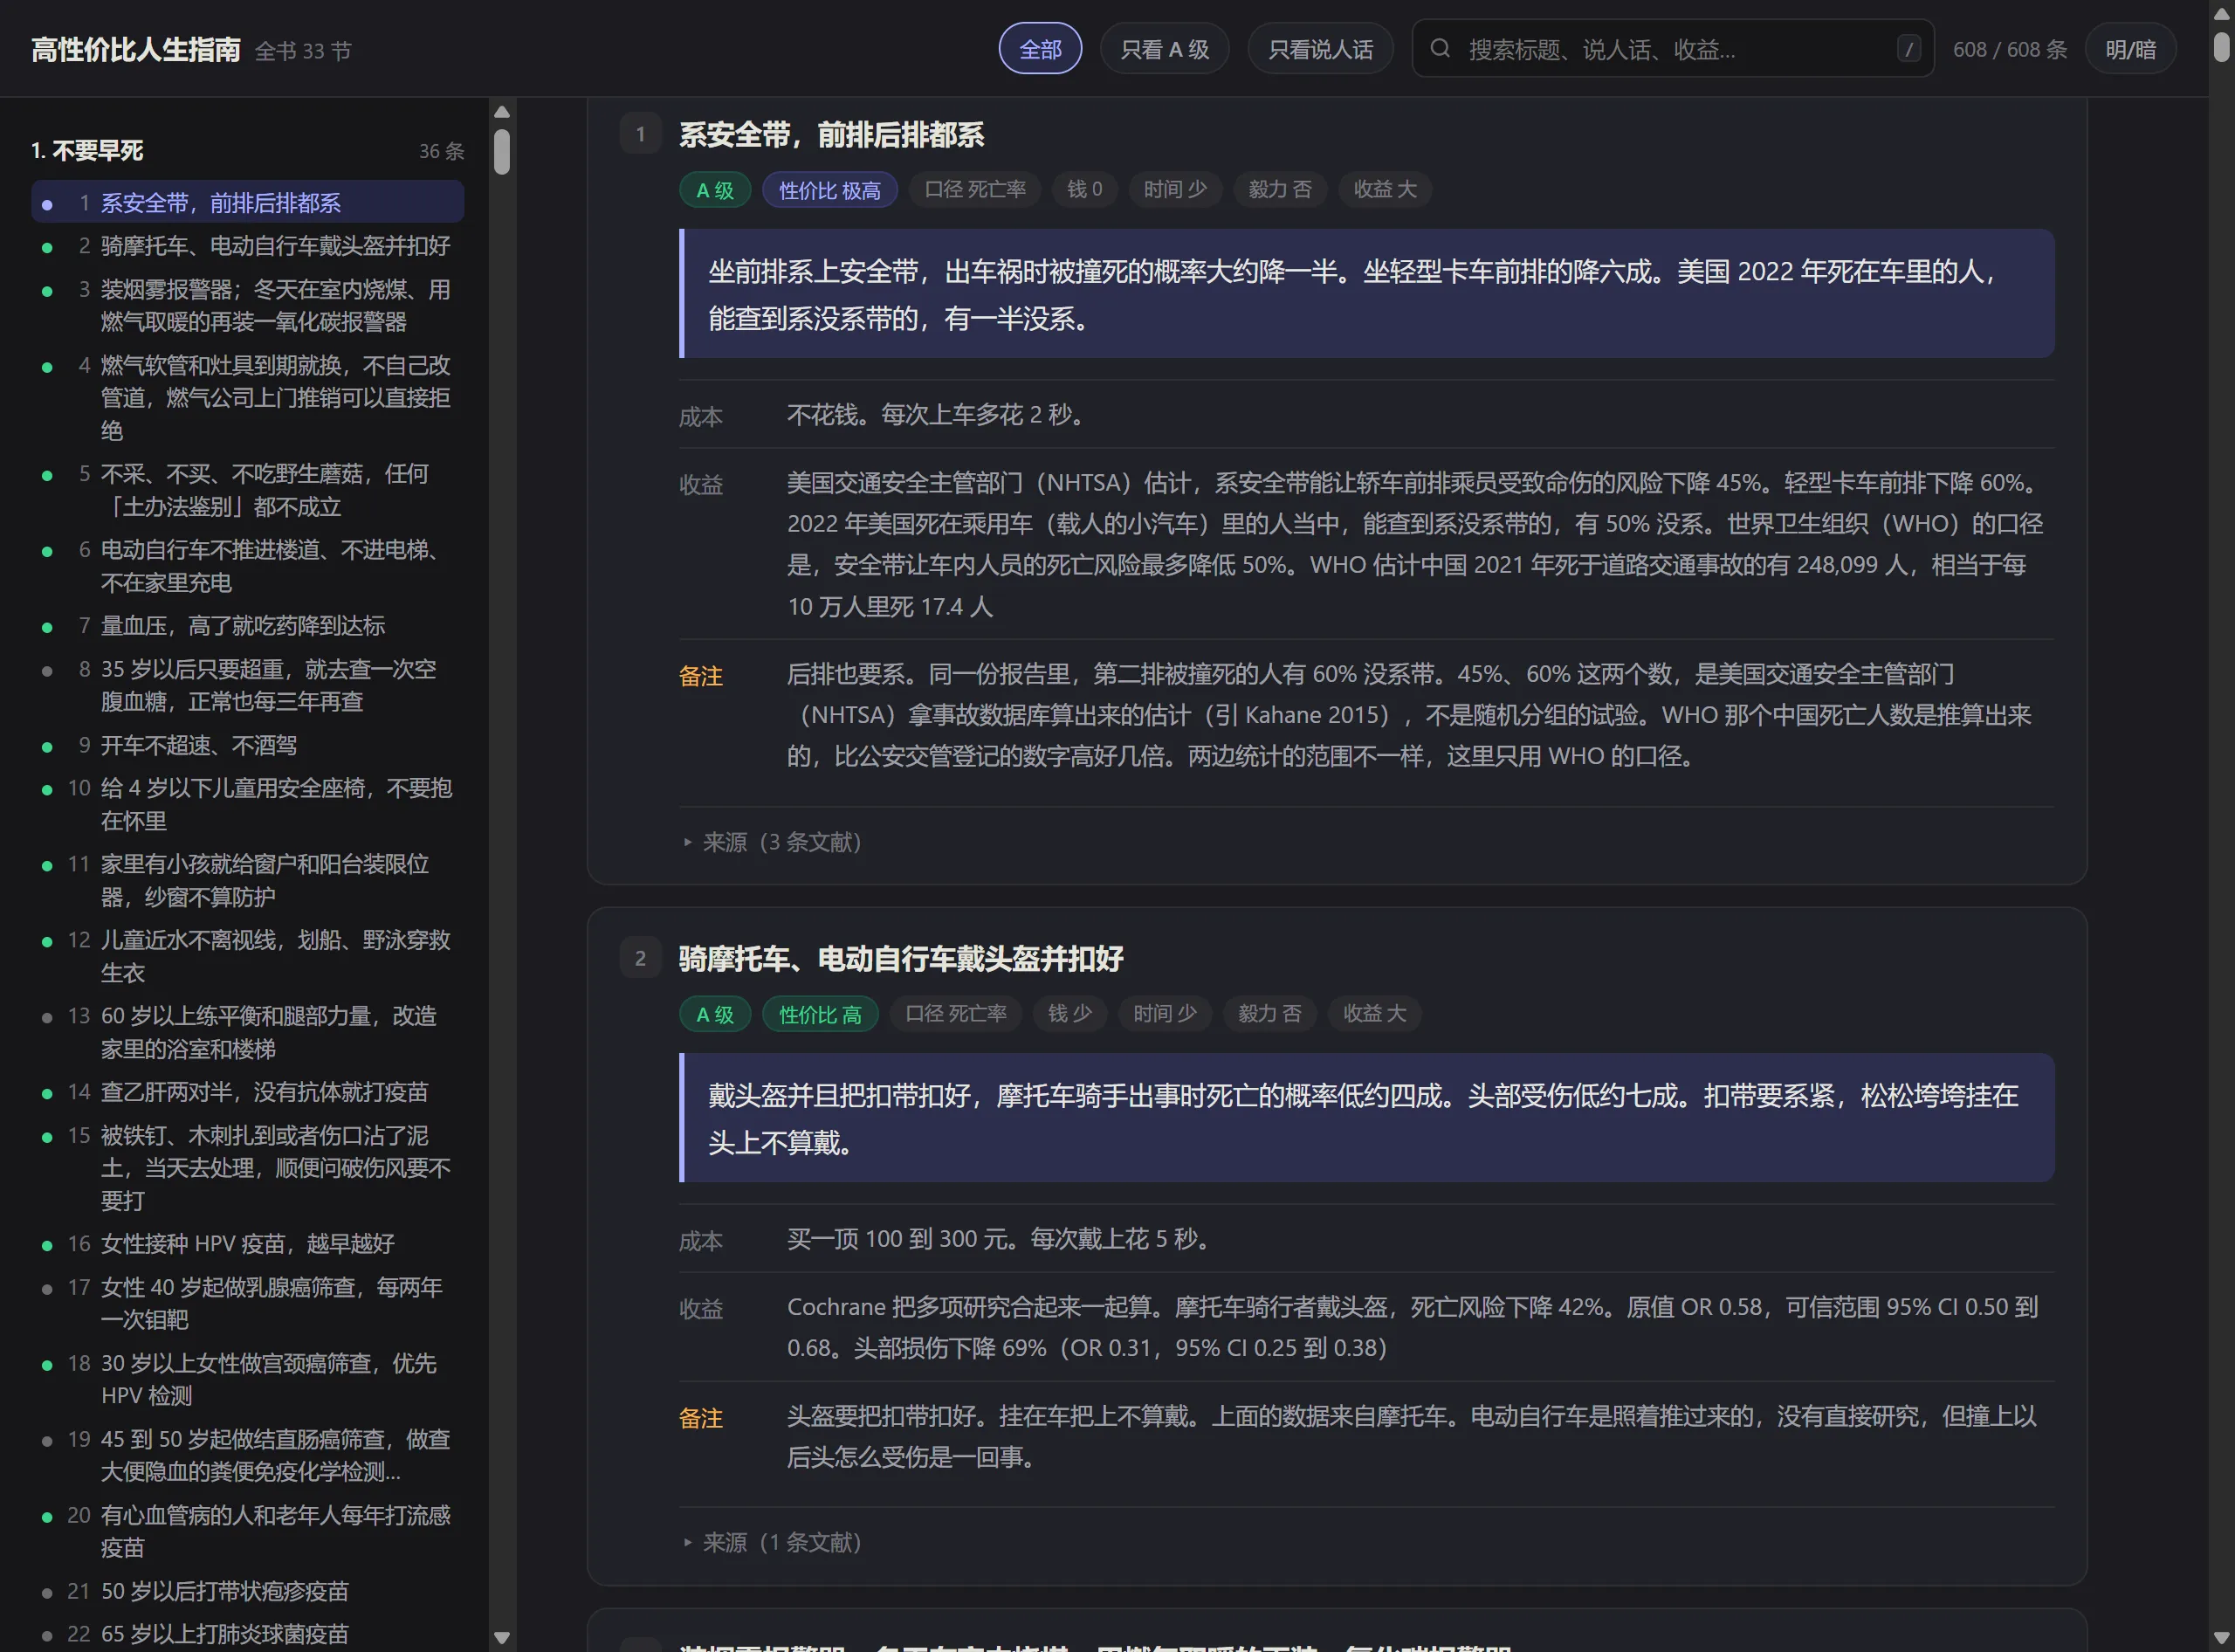
解析对象:《高性价比人生指南》在线阅读页(第三方单文件渲染版)· 原书仓库 eternity4719/HowToLiveBetter(Unlicense 公有领域)。文中数据(条目数、star 数等)均为我 2026-09-27 抓取核对时的快照,这本书几乎每天都在更新。三张截图分别截自在线阅读页与原书仓库。
这是一个值得认真拆一次的对象。9 月 7 日有人在 GitHub 上开了个仓库,写一本中文的「人生指南」:把长寿、防病、急救、省钱、法律红线、失业工伤、恋爱婚育、怀孕育儿这些八竿子打不着的话题,全部塞进同一把尺子——性价比——底下量一遍,每条建议写清花掉什么、换回什么、证据有多硬,来源只引期刊论文和官方文件。20 天后,这个仓库有 19,567 个 star、1,382 个 fork;第三方阅读页、英俄西三语翻译、Android App、Claude Code skill 各自长了出来。
我的结论先放在前面:证据纪律 A,工程化 A+,通俗化 A,价值立场 B+,长期可持续性存疑。它不是通常意义上的「爆款网文」——正文的 1281 条来源链接里没有一条知乎和公众号;它也不像「AI 生成的垃圾」——恰恰相反,它是我见过的把「防 AI 幻觉」做得最工程化的中文知识项目,一本用 Claude Code 维护、把每次事实核查都留档的开源书。它的真正价值有两层:表层是一本中文互联网罕见的循证生活指南;底层是一套可复制到任何领域的「AI 辅助知识工程」范式。下面逐层展开。
一句话定位
把 Cochrane(循证医学协作组织)综述的引用纪律、精算师的口径意识和居委会大妈的话题覆盖面,装进一份可以双击打开、断网可读的单文件 HTML 里——并且整本书由作者加 Claude Code 按「规则即判例」的方式维护,每个数字都能查到核实过程。
书自己的一句话定位(README 开头):「608 条建议,每条写明花掉什么、换回什么、证据有多硬,来源只引期刊论文和官方文件。不用全做:这是按性价比排好的备选单,不是任务清单——挑走一两条就算数,作者自己也没做到其中大部分。」
这个「作者自己也没做到其中大部分」的姿态值得先记下:它从头到尾没有「教你做人」的口吻,写作规则里明文写着「语气克制,不说教,不用感叹号」。
它是什么:一本书的三层档案
先厘清对象,因为这次解析的入口 URL 本身就很有意思——你看到的那个页面不是原书,是生态的一部分:
- 入口层(用户给的 URL):cdyforever.github.io/how-to-live-better 是开发者 cdyforever 做的第三方在线阅读页——把原书 33 节渲染成一个零依赖、可搜索、支持离线的单文件网页(index.html 一个文件 2 MB,双击就能开)。仓库 2026-09-18 创建,9 天 1,792 star,GitHub Actions 每天北京时间 06:00 拉上游重新生成。README 明确声明「不是原书的 fork,也不改动原书内容」。
- 原书层:eternity4719/HowToLiveBetter,2026-09-07 创建,Unlicense(公有领域,放弃所有权利)。正文按节拆成
book/01-*.md到book/33-*.md共 33 个文件约 1.5 MB——拆分原因是单文件超过了 GitHub 渲染 Markdown 的 512 KB 上限。作者 GitHub 昵称「永恒世界」,账号 2025 年创建,无 bio、无博客链接,提交署名 albert4719,全网几乎没有其他公开痕迹。README 最底下唯一的「商业闭环」是一张作者自己运营的 Minecraft 服务器广告(mcyyy.com)——一本放弃版权的书,靠一个游戏社区用爱发电。 - 生态层:dlgrv 维护的英/俄/西语翻译(只挂链接、不合入主仓库——作者的原则是「看不懂的语言合进来就是盲合」);issue #34 有人做了 Android App 来报备;issue #23 有人 fork 做了极简书页版式;PR #20 由外部贡献者 Floyd Chen 合入了官方配套的 Claude Code/Codex skill。一本书 + 一个阅读页 + 三语翻译 + App + skill,20 天长出一个微型生态。
书的规模(2026-09-27 快照):33 节、608 条建议,证据分级 A 级 410 条 / B 级 149 条 / C 级 49 条,56 条标注「争议」,35 处标注「TODO 待核实」,1281 条原始文献链接,另有 5 篇长文(结婚划不划算、家庭应急装备清单、做平台要办哪些证、遇到陌生人出事该不该停、生物钟和夜班)和 92 份逐条来源核实记录。
思想谱系:它从哪来
书的项目规则(CLAUDE.md)第一段就交代了血统:「参考 geekan/HowToLiveLonger 的量化风格,但范围更大」。
- 直接前身:geekan/HowToLiveLonger(程序员延寿指南,2022 年 4 月创建,35,267 star)。geekan 是 MetaGPT 的第一作者,那份指南用「ACM(总死亡率)」这种程序员黑话把长寿干预按证据强度排了序,是「把循证医学方法搬进中文个人发展领域」的起点之作。《高性价比人生指南》继承了它的量化风格,但做了一次关键的扩维。
- 那次扩维:从优化一个目标(寿命)变成优化四种资源——寿命、时间与精力、金钱、人身自由。这个扩维让全书能覆盖 geekan 版本不可能覆盖的内容:法律红线(人身自由)、反诈和省钱(金钱)、拖延和精力管理(时间)。
- 更远的源头:往西追溯是循证医学运动(Cochrane 系统综述、GRADE 分级——术语表里都有),以及决策科学里的期望值思维;往本土追溯,它的真正对标物其实是「家庭生活常识」这个品类——只不过把「我妈说」「老中医说」「朋友说」全部换成了「三万人随机分组试验说」。
这个谱系里它站的位置相当清楚:HowToLiveLonger 回答「怎么活得久」,它回答「怎么活得不亏」。
方法论拆解:这把尺子是怎么造的
这是全书最精彩的部分,分五层。
1. 四种资源,彼此不折算
全书第一性的设计决定:寿命、时间与精力、金钱、人身自由四种资源,各算各的,绝不互相折算。「总死亡率降 12%」和「每年省 500 元」不在一把尺子上,没法分高下——所以检索页的「换回什么」是四个并列的口径,不是一个总分。这回避了所有「命值多少钱」式的脏问题,也让「性价比」有了严格的定义域:只在同口径内部排序。
2. 受益人四档:一个精算师式的原创设计
一条建议的好处落在谁身上?书分四档,按「好处将来回到你身上的概率」从高到低:① 你自己;② 配偶和直系亲属;③ 朋友同事和其他亲属(互惠关系);④ 陌生人(回报概率小,还要把被讹、被反咬、被报复的风险面一起写)。不同档不合并计算。
这个设计直接决定了「急救」话题的写法:中国 38,227 例院外心脏骤停里 79.2% 发生在家里,所以「学心肺复苏」首先是为了按在自家人身上;而「看到有人溺水自己不下水」这类规则本身就是自保规则。书不替你把「救陌生人」算成道德义务,也不写成「一律别管」——把免责条款、自保动作和风险面摆全,让你自己权衡。这是全书价值立场最鲜明也最克制的地方(后文批判部分再回到这点)。
3. 证据分级:A/B/C 与「说人话」的分工
- A 级:有具体数字可查,出处是荟萃分析、大型队列或随机对照试验(RCT),能说出降了多少(HR、RR、下降百分比)。
- B 级:有研究支持但说不出确切数字,或只有小样本、单一研究。
- C 级:作者经验或公认做法,没有直接文献。
关键是分级之上还有一个翻译层:「说人话」栏。每条建议把「收益」栏里的统计量翻成日常语言——「死亡风险下降约六成。原值 OR 0.39,可信范围 95% CI 0.18 到 0.83」变成「一个能正常工作的烟雾报警器,能把住宅火灾里死亡的概率降约六成」。而且这一栏被规则严格约束:不许出现收益栏里没有的数字,不许加收益栏没写的症状和机制解读(项目规则里记着两次翻车案例:一次「说人话」里冒出了来源从没提过的「脸色差」,一次把「病假次数少了」自行解读成「病了也照样上班」,都被用户抓出来改掉)。这个约束本质上是给 AI 翻译层上了防幻觉的笼子——翻译只能降维,不能添油。
4. 性价比档:不入库的前端实时合成
每条除了证据等级,还有性价比三档(极高/高/一般)。有意思的实现:这个档不写进仓库,而是由检索页的 index.html 按规则实时计算——每条条目里藏着一行 HTML 注释(<!-- 成本标签: 钱=0 时间=少 毅力=否 收益=大 口径=死亡率 -->),前端拿「收益量级 + 三项成本」合成档位。单一事实源、无双重维护,改规则只改一处。收益量级的判定也是机械的阈值(死亡率口径:相对降幅 ≥20% 为大,10–20% 为中……),不凭感觉。
书里对这一档的诚实程度罕见地高:「这一档是作者自己的判断,不是证据,按本书的标准它本身只算 C 级」。它举的例子很说明问题:带状疱疹疫苗有 97.2% 效力的三期 RCT(证据 A 级),但两针三四千元、病很少致命(性价比一般);「出境前把行程发给家人」没有任何文献(证据 C 级),但零成本防大祸(性价比极高)。
5. 条目解剖
拿真实的第 2 节第 9 条「把家里的食盐换成低钠盐(钾盐)」看整体结构:
- 成本:一袋比普通盐贵几元。买的时候顺手换,不额外占时间。口味几乎不变。
- 说人话:两万人的随机试验里,把家里的盐换成低钠盐的人,五年内死亡的概率低约 12%,中风低约 14%。这是随机分成两组比出来的,比只跟踪记录得到的数字更可信。
- 收益:一项把人随机分成两组的试验,在中国农村做的,20995 人,都是得过卒中的人或者 60 岁以上的高血压病人,跟踪了 4.74 年。结果:用低钠盐的那组比用普通盐的那组,死亡风险低约 12%(RR 0.88)。卒中低约 14%(RR 0.86)。主要心血管事件低约 13%(RR 0.87)。
- 证据等级:A
- 来源:Neal B 等 (2021). Effect of Salt Substitution on Cardiovascular Events and Death. NEJM. doi:10.1056/NEJMoa2105675;O’Donnell M 等 (2014). Urinary sodium and potassium excretion, mortality, and cardiovascular events. NEJM.(争议方 PURE)
- 备注:争议。PURE 这项研究只长期跟踪记录,不分组。它报告:一天排钠不到 3 g 的人,死亡加心血管事件的风险高约 27%……但本条引的那项中国农村随机试验里,低钠盐只是替换掉一部分,不会把钠压得那么低。另外要注意,试验对象是高危老人。健康年轻人换盐得到的好处要小得多。肾功能不全的人,或者正在吃保钾类药物的人,换盐前先问医生。
八个字段各司其职:标题动词开头、成本栏可感、说人话栏自足(只读这一行就能拿主意)、收益栏保留全部原值(可核对性的底座)、备注栏永远先亮争议和适用人群——注意这条 A 级条目的备注里主动列了反方研究(PURE 队列认为钠吃太少也有风险),并解释了为什么本条的随机试验不受它动摇。
6. 反面清单:把「不该做什么」当一等公民
第 6 节「反面清单」是全书最有传播力的一节:26 条「不要」,每条都在打一个有营销预算支撑的流行说法——复合维生素、普通鱼油、抗氧化补剂、氨糖、维生素 C 防感冒、无症状者的全身 PET-CT、有机食品溢价、益生菌、靠洗冷水澡「增强免疫力」、「每天 8 杯水」、排毒清肠酵素、花钱算命做决定、防蓝光眼镜、把献血当保健、通用体检套餐、水晶手串、靠购物调节情绪、为了「往上挪一档」换房换车换圈子……甚至包括两条对流行心理学的祛魅:「意志力像肌肉会用完」(23 个实验室、2141 人的预注册重复研究,效应量 d=0.04,约等于零)和「不吃早餐会暴食 / 16:8 更减肥」(随机试验里不吃早餐的人一天总摄入反而低 259.79 kcal)。
大多数人生指南只写「该做什么」;这一节写的是否定性知识——它防的不是无知,是精心包装过的错误。在一个保健品和知识付费年产值千亿的市场里,这 26 条「不要」的期望价值可能比前五节所有「要」加起来还高。
独立抽查:我亲手核了 10 个数据点
一份「每条都可核查」的书,解析它的最低要求是真的去核查。我从头两节和反面清单里抽了 10 个数据点,对照核实记录里的原文引语和我自己掌握的文献:
| 书中的说法 | 来源 | 我的核对结果 |
|---|---|---|
| 安全带使轿车前排致命伤风险降 45% | NHTSA 2024 报告(DOT HS 813 573) | 与 NHTSA 公开口径一致,核实记录里有逐字引文 |
| 摩托车头盔使死亡风险降 42% | Liu BC 2008, Cochrane(OR 0.58) | 与该 Cochrane 综述已发表结论一致 |
| 正常工作的烟雾报警器降火灾死亡约六成 | Marshall 1998, JAMA(OR 0.39) | 真实存在的研究,数值相符 |
| 收缩压每降 10 mmHg,心血管事件 RR 0.80、总死亡率 RR 0.87 | Ettehad 2016, Lancet(123 项试验荟萃) | 与该荟萃已发表数值一致 |
| 中国 35–75 岁高血压 44.7%、控制率仅 7.2% | Lu 2017, Lancet(China PEACE,170 万人) | 与该研究一致 |
| 低钠盐降总死亡率 12%(RR 0.88) | Neal 2021, NEJM(SSaSS 试验) | 与该 RCT 一致,备注里「高危老人」的人群限定准确 |
| 17 岁前接种 HPV 疫苗降宫颈癌约 88% | 瑞典 170 万人队列 | 与 Lei 2020, NEJM 一致 |
| 普通人吃鱼油无用,但高危病人的处方级纯 EPA 有效 | VITAL/ASCEND vs REDUCE-IT | 三试验的区分做得非常准——这是营养补充剂领域最常见的混淆点,书把 REDUCE-IT 明确标注为「给高危病人的大剂量处方药,不等于保健品鱼油」 |
| 「意志力像肌肉会用完」效应≈0 | Hagger 2016 多实验室预注册重复 | 23 个实验室、2,141 人、d=0.04,与该研究完全一致 |
| 不吃早餐的人一天总摄入低 259.79 kcal(驳「不吃早餐会暴食」) | Sievert 2019, BMJ 荟萃 | 数值一致,且这正是该荟萃最反直觉的真结论 |
10/10 通过,零幻觉、零数字漂移。 更让我意外的是核实记录的工作方式:docs/核实记录/ 下 92 份档案记录了每条的核查过程,连「NEJM、Elsevier、Wiley 的网站对 WebFetch 返回 403,改走 Europe PMC REST 接口读同一 DOI 的摘要全文」这种工程细节都留了档,每个数字旁边贴着从原文抓到的英文原句。这不是「声明可信」,这是「出示工作过程」。
同时要如实报告核查中发现的瑕疵:GitHub 对条目数的元数据在不同层面有滞后(原书 README 正文 608 条、第三方阅读页的 meta 描述 601 条、其仓库简介 528 条——三个数字并存,都是历史快照没跟上更新);书内也有 35 处自标的「TODO 待核实」(比如「闻到燃气味之后的标准处置步骤,本次没取得可以逐字核对的官方原文」)——发现自己核不了什么就标出来,而不是糊一个过去,这反而是可信度的加分项。
批判与局限:八条
一份 A 级证据密度这么高的书,批判也要按它的标准来。以下每条我都尽量给出书内的对应处理(公允地说,它对其中大半有自觉)。
- 相对风险为主轴,绝对风险呈现不足。全书以 RR/HR 为主线,说人话栏的「低约 12%」也全是相对量。对低基率事件(如年轻人群的心血管死亡),相对降幅会显得比实际大。术语表里有「风险差」这一条(「直接得出每一千人里多出几个」),但正文很少系统使用。这是全书最实质的方法论短板。
- 人群外推的裂缝。A 级证据大量来自欧美人群(安全带来自 NHTSA、烟雾报警器来自美国北卡研究、饮食运动队列多为欧美),用在中文读者身上有距离。书对此有零散自觉(低钠盐条写明「对象是高危老人」,道路死亡条同时给出 WHO 推算值和「比公安交管登记数高好几倍」的口径警告),但没有系统标注「该证据来自哪个人群」。
- 「极高性价比 104 条」榜单的口径混杂。检索页勾「性价比极高」得到 104 条,混合了死亡率、金钱、自由四种口径——虽然书反复强调不折算、也提示「再叠加一个换回什么」,但单一榜单的呈现方式天然诱导读者当成统一排行榜扫一遍。
- 政策时效是长期最大的坑。第 7、19、21、24、31、32 节里的金额、时限、名单(补贴、时效、签证规则)会持续漂移。书的对策是「正文写截至日期 + 读者自查官方渠道」,issue #32 那次美国 F-1 签证新规被法院暂停、一天内改正——社区纠错飞轮目前转得很快,但 608 条的政策条目靠单人 + AI 长期盯,衰减只是时间问题。
- 受益人四档是利己期望值框架。把利他行为折算成「好处回到你身上的概率」,这个精算视角自洽(书明确写了第 ④ 档不是零、风险面好处一起摆),但它是立场不是科学——书自己也承认这类判断按其标准只算 C 级。读者应当意识到自己在接受一套「家庭优先」的伦理预设。
- A 级内部质量差异被压平。荟萃分析、大型队列、RCT 并列 A 级,但荟萃的输入质量、队列的混杂控制天差地别。书用两个办法缓解:说人话里常写「这是随机分组比出来的,比只跟踪记录更可信」,术语表教读者「观察性数字要打点折看」——但分级本身不降级,比 GRADE 的四档「证据质量」粗。
- 饮食睡眠类条目吃观察性研究的老本。第 2 节不少「降约两成」来自大型队列,健康人效应和混杂无法根除。书标了 56 条争议、并在午睡等条目上展示了「观察性说风险高、孟德尔随机化不支持」的两面,态度端正,但读者容易把 A 级当定论。
- 法律条目的通用口径边界。「写过程成本」的规则(胜诉要写打多久官司、律师费谁掏)是同类内容里罕见的诚实,但 608 条不可能覆盖个案——配套 skill 里写的边界就是答案:「涉及具体案件要找律师,别替专业人士下判断」。
顺带一提 issue 区的两极:一边是高质量纠错(#28 八处逐字引用补文献、#30 法律遗漏、#27 反驳喝茶结论),一边是「菩萨!」「哦」「谢谢主播」——一本书火出圈之后,社区信噪比的管理会是下一个课题。
它为什么 20 天近 2 万 star
传播这事我只能给假说,但有几条相当扎实:
- 供给侧的真空。中文互联网的健康、法律、理财信息被 SEO 农场、带货自媒体和「亲测有效」体长期统治,「只引原始文献、每个数字可核对」的中文汇编是真正的稀缺品。它填的不是知识空白,是信任空白。
- 工程完成度决定传播半径。在线检索页(可按证据等级、成本维度筛选)、离线单文件 HTML(微信里能直接传)、A4 排版 PDF、EPUB、Claude skill——一本书同时交付五种形态,转发成本被压到最低。Unlicense 公有领域去掉了最后一层心理摩擦。
- AI 时代的反向信号。在「AI 生成垃圾」泛滥的 2026 年,一份「AI 辅助生产、但每个数字有 DOI、每次核查有留痕」的文本,本身就是一种稀缺的信任结构。它的走红可以读作市场对「过程可审计的知识品」的定价。
- GitHub star 的马太效应。9 天 1,792 star 的第三方阅读页反哺了原书的可见性,翻译、App、fork 又各自引流。这个飞轮目前还在加速。
元层面:一本用 Claude Code 维护的书怎么防幻觉
这是对本书读者(也是本博客读者)最有迁移价值的部分。整本书的维护工作流是作者 + Claude Code,而项目把「怎么让 AI 长期不改错地维护一本有 608 个条目、500 多处交叉引用、1281 条文献的书」做成了一套工程。拆开看有六招:
① 规则即判例的 CLAUDE.md。 50 KB 的项目规则,几乎每条规则后面都跟着日期和触发事件:「2026-09-21 用户抓的:我把『要不要死记硬背』问错了写成了条目标题,他说『你这是给我写的吧,读者又没问』」→ 于是立规「条目是写给读者的,不是回答提问的人」。这不是 style guide,这是用判例法喂养的机构记忆——每条规则都能追溯到一次真实失误,AI 重犯同一错误的概率被结构性压低。类似的还有:「别因为选择代价高就当成没有出路」(用户:有些人为健康就换工作呢,总比没有好)、「先确认你要驳的是读者真信的那句话」。
② 引用防错位三件套。 一本按「第 X 节第 Y 条」互相指路的书,最大的隐性 bug 是:中间插一条,后面所有条号顺延,而顺延后的条号通常仍在合法范围内——引用指错了人也查不出来。对策是三层:每处引用必须带锚点(引用的句子里要有词和目标标题对得上,连续三个汉字或同分句两个汉字才算,防止「你自己还」这种常见词冒充锚点);每次改动重新生成 docs/引用对照.md(每处引用实际指向的条目标题列表,入库、看 diff);CI 跑独立的交叉引用检查 job。项目规则里甚至记着灵敏度实测:「把节内引用整体顺延一条,能当场拦下约七成,剩下的只能靠对照表 diff」——知道自己的检查器抓不到什么,这个意识本身就是范本。
③ 守恒判据抓静默失效。 「新增 N 处引用,对照表总数就该涨 N。涨少了说明有引用被当成法条跳过——它压根不进对照表,检查反而显示通过,是静默失效。」用总量不变式做校验,这是分布式系统的思路用在了文档上。CLAUDE.md 里记了三类「检查显示通过但其实没查」的失效模式(法条过滤误判、扫描范围不含节首和长文、Windows-only 的本地链路),每一类都是事后全量扫描抓出来的。
④ 说人话栏的翻译笼子。 前文提过:翻译层「不许出现收益栏没有的数字、症状、机制解读」。这是对 LLM 最典型失败模式(顺手补细节)的针对性约束,而且配了两个真实翻车案例做教具。
⑤ 统计同步脚本消灭人肉一致性。 条目数、A/B/C 数量、链接数散布在 README 八处、检索页、OG 图等十几个位置。sync-stats.ps1 一键重算回填并重出 og.png(含「图片必须是本次写入、大小 120–400 KB」的自检),项目规则要求「每次改完条目就跑一次,和正文改动一起提交」。配套的设计是单一事实源:性价比档不入库由前端实时合成;skill 里「不放会跟着正文漂移的副本,档位算法当场去 index.html 里抠那两行」。
⑥ 通俗化的量化验收。 2026-09-21 那天,因为有人评论「AI 生成的垃圾看不懂」,全书 552 条和四篇长文按新标准(一句一件事、30 字上下、每句有主语、每句能单独读懂)逐条重写,句子平均长度从 66 字降到 29 字,超 70 字的句子从 1385 句降到 64 句(剩下的全是不可拆的法条引文和文献题录)。动机写得很清楚:照顾读得慢、逐字逐句看的老年人和残障读者。有验收指标的可读性改造,而不是「写通俗点」的愿望。
再加上一层态度上的:核实记录就是 AI 工作的审计日志。92 份档案,记录了哪个数字来自哪个 DOI、原文那句话长什么样、哪个点核不了标 TODO。它把「AI 参与生产」从需要隐瞒的嫌疑变成了可以出示的过程。这一整套东西——判例法规则、防错位工程、守恒校验、翻译笼子、统计同步、量化验收、审计留痕——可以原样搬去维护任何领域的长期知识库:法律汇编、内部 wiki、产品文档、研究笔记。
怎么用这本书
按投入从低到高:
- 五分钟版:打开在线检索页,勾「性价比极高」,得到 104 条不花钱、不花时间、不需要毅力、收益又是最大一档的条目(系安全带、出境前把行程发给家人这类),挑三五条当场能做完的。想只看证据最硬的,再叠一层「证据等级 A」(410 条)。
- 人生事件版:把它当索引用。搬家看第 15 节,被裁看第 19 节,怀孕看第 27 节,家里老人看第 17 节,遭遇丧亲看第 29 节。每个节就是一个事件 checklist。
- AI 原生版:装官方 skill(skills/life-decision-guide,Claude Code 和 Codex 通用),然后直接问「替朋友担保签不签」「每天通勤两小时值不值」——它会先把相关条目从正文里查出来,按书里的算账方式排序回答,注明出自第几节第几条,查不到就直说查不到,不自己编数字。
- 无论哪种用法:政策类条目看清「截至日期」;带「争议」标注的一定读备注栏;它不替代医生、律师和会计——书自己把这话说在了最前面。
结语:它真正留下的是什么
一本书 20 天近 2 万 star,热度会过去;但它示范的两样东西会留下来。
第一样是中文知识品的信任结构:证据分级、来源可溯、过程留痕、争议亮明、核不了就承认。这五个动作在任何领域都成立,在 AI 生成内容泛滥的年代,它们正在从「学术美德」变成「内容品的准入门槛」。
第二样是人机协作维护长期知识库的工程范式。一个几乎匿名的作者,用 Claude Code 和一套「规则即判例」的纪律,维持住了 608 个条目、500 多处交叉引用、1281 条文献的零幻觉记录(至少我抽的 10 个点全部通过)。它证明的命题很具体:AI 幻觉问题可以被组织手段压到可接受区——不是靠模型更聪明,是靠引用纪律、防错位工程和审计留痕。
风险也同样具体:单人维护的热情周期、政策条目的时效衰减、出圈后的社区信噪比,以及那个始终存在的哲学问题——一本教人「按性价比活着」的书,和书尾那张 Minecraft 服务器广告一样,都是某个具体的人对「好生活」的具体想象。它自己说得好:「不用全做,这是备选单,不是任务清单。」
核查说明:文中所有关于该书的事实(条目数、分级分布、star 数、提交历史、issue 与 PR 内容、CLAUDE.md 规则、核实记录工作方式)均取自 2026-09-27 对 eternity4719/HowToLiveBetter 仓库 API 与原始文件的直接抓取;10 个数据点抽查基于核实记录原文引语与我对相应文献的独立掌握。该书每日更新,数字以仓库当前状态为准。